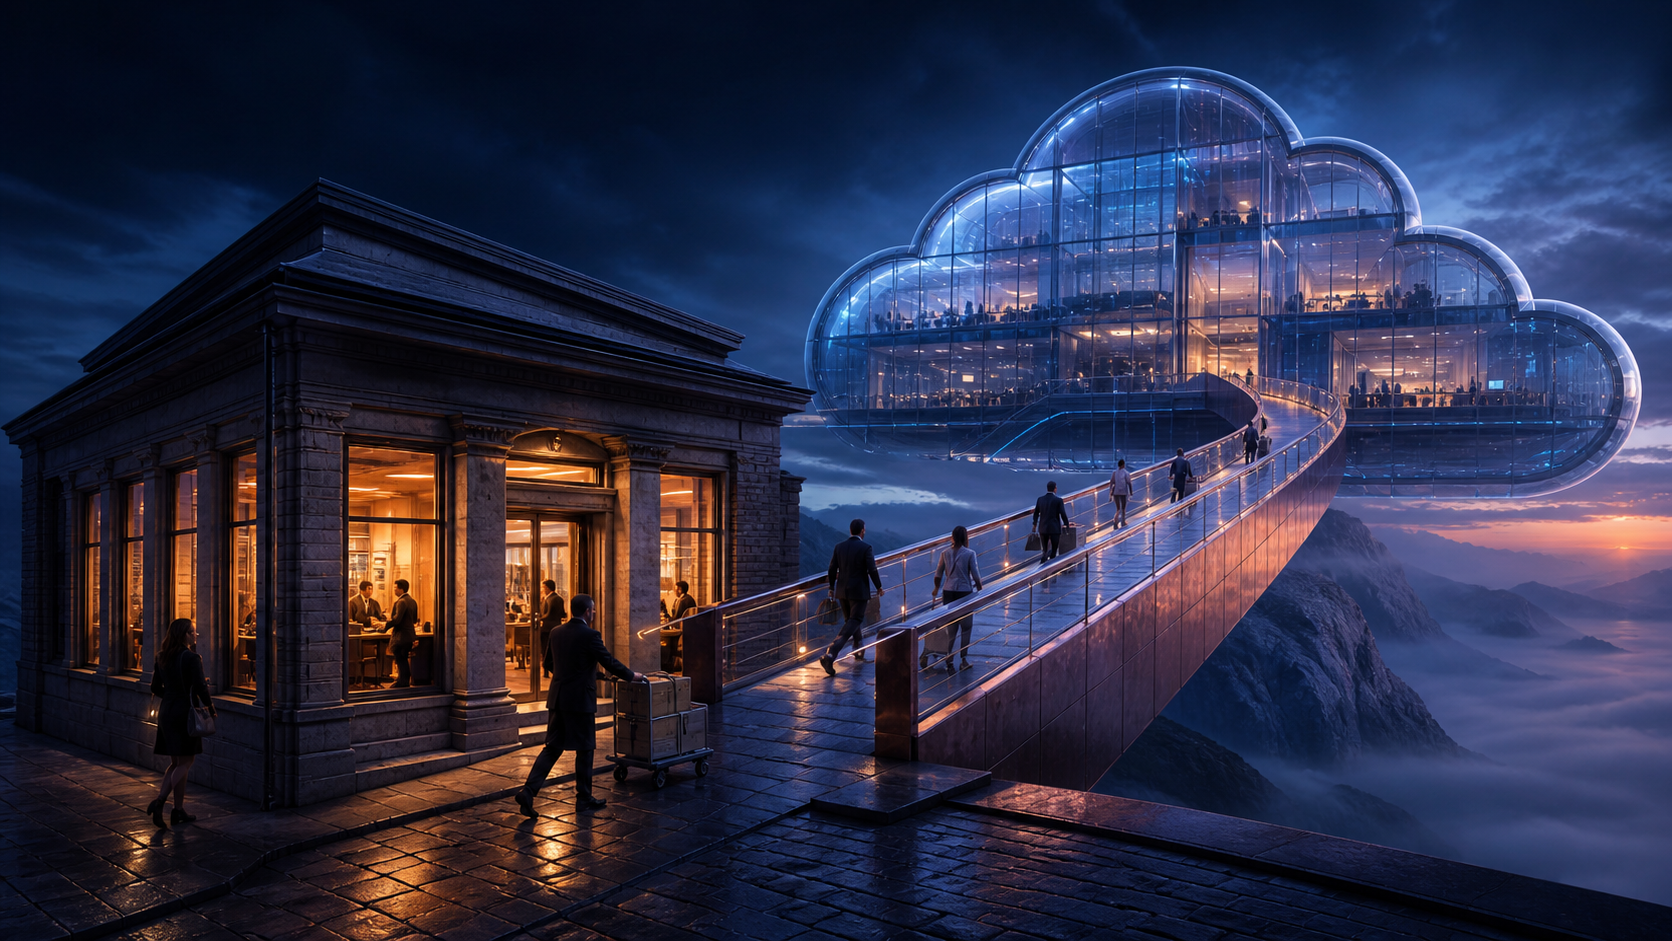
Brief éditorial. Un cadre de migration par étapes fondé sur la réversibilité, l’observabilité, les dépendances et la confiance opérationnelle. la planification de migration d’Arcadia comme progrès réversible.
quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer une séquence de découverte, fonctionnement parallèle, bascule et apprentissage.
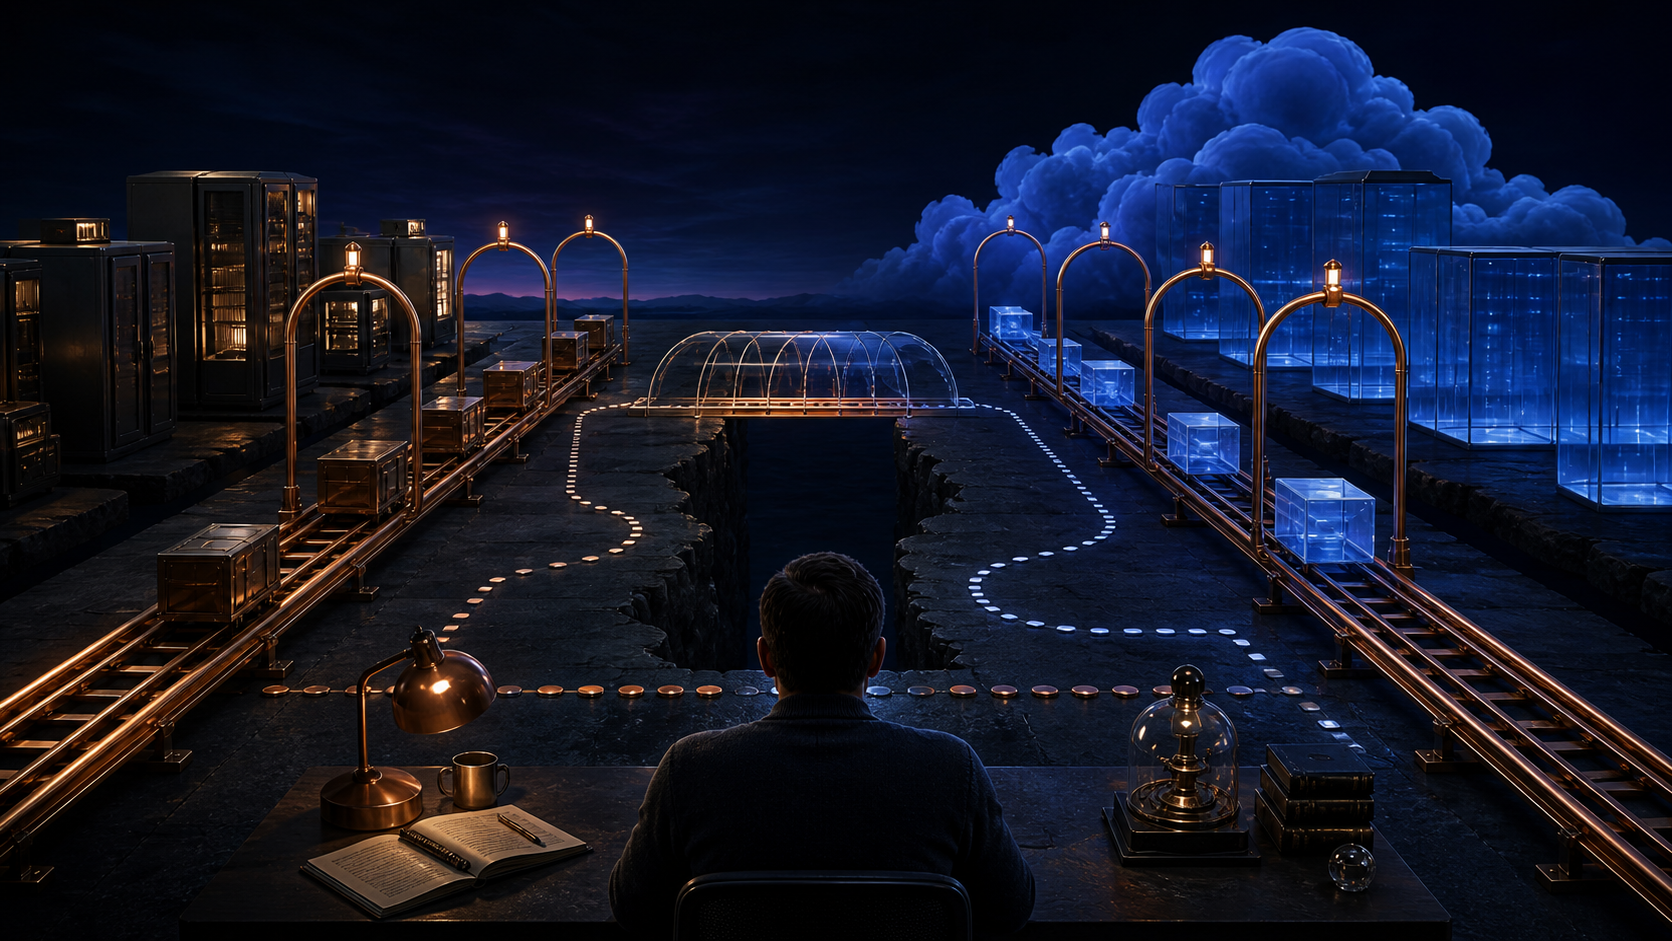
Question directrice. quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables.
Note de méthode. Ce brouillon distingue preuves, interprétation, action et revue afin que l’article puisse être questionné avant publication.
La thèse qui guide l’article
La lecture pratique de la migration cloud comme changement contrôlé d’une activité vivante commence par cette observation : Migrer est une suite de décisions de risque, pas un événement d’infrastructure unique. Dans la section « La thèse qui guide l’article », elle compte parce que quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. Les preuves à examiner sont dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables ; sans elles, l’équipe peut confondre une explication séduisante avec une explication fiable. Un geste opérationnel utile consiste à répéter la reprise avant de demander à la production de faire confiance à la migration. Cela donne à une séquence de découverte, fonctionnement parallèle, bascule et apprentissage une limite visible, rend possible confiance dans la reprise et minutes d’impact client par phase et permet de revenir sur la conclusion lorsque la date de bascule prenne le pas sur la continuité de service.
Un système devient concret lorsqu’il est confronté à une situation comme une entreprise avec un système legacy critique et peu de tolérance à la panne. Dans ce cas, Les cartes de dépendances transforment la surprise en question que l’on peut répéter. L’équipe doit donc demander quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer avant de choisir un outil, un modèle ou une réunion. une séquence de découverte, fonctionnement parallèle, bascule et apprentissage compte parce qu’il transforme une ambition vague en séquence inspectable. L’action recommandée est de répéter la reprise avant de demander à la production de faire confiance à la migration puis de comparer le résultat avec dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. Si le résultat ne peut pas être expliqué, le problème n’est pas seulement l’exécution : il se peut que la date de bascule prenne le pas sur la continuité de service.
La couche de preuves change la qualité de la décision. Ici, dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables doit être considérée comme une matière à relire, et non comme une décoration autour d’une réponse déjà décidée. Le fonctionnement parallèle fournit des preuves, mais crée une charge temporaire de cohérence. Une équipe attentive consigne ce qu’elle attendait, ce qu’elle a observé et ce qui reste ouvert. Elle utilise ensuite confiance dans la reprise et minutes d’impact client par phase comme signal d’apprentissage, pas comme badge. C’est essentiel lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, car les contraintes locales peuvent révéler des hypothèses seulement plausibles.
Mettre en œuvre ne signifie pas courir du concept au logiciel. Cela signifie choisir une action bornée : répéter la reprise avant de demander à la production de faire confiance à la migration. La raison est simple : une séquence de découverte, fonctionnement parallèle, bascule et apprentissage ne peut être fiable que si chaque transition possède un responsable et une condition visible. Le retour arrière n’est crédible que s’il est plus rapide que l’improvisation. En pratique, l’équipe doit préserver un petit point de revue avant d’élargir le périmètre. Cette revue demande quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, inspecte dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables et note si confiance dans la reprise et minutes d’impact client par phase a changé. Sinon, la date de bascule prenne le pas sur la continuité de service ne sera découvert qu’une fois le changement coûteux.
Le contre-argument mérite une écoute honnête. Une équipe peut dire que la migration cloud comme changement contrôlé d’une activité vivante est trop nuancé pour une méthode répétable, ou que documenter ralentit le travail. La réponse n’est pas de supprimer la structure, mais de la garder proportionnelle à la conséquence. L’observabilité doit dire si l’activité reste saine, pas seulement si les serveurs répondent. La version minimale comprend une question, un responsable, une source ou observation, une décision et un chemin de retour. Cela suffit pour rendre la planification de migration d’Arcadia comme progrès réversible réelle tout en reconnaissant que la date de bascule prenne le pas sur la continuité de service. Cela protège aussi confiance dans la reprise et minutes d’impact client par phase contre la réduction à un chiffre séparé de la pratique.
La leçon durable de cette section est que une migration s’achève lorsque l’équipe sait exploiter le nouveau système un jour difficile. L’équipe peut la traduire en règle : partir de quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, rendre dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables disponible, organiser le travail avec une séquence de découverte, fonctionnement parallèle, bascule et apprentissage et relire confiance dans la reprise et minutes d’impact client par phase après l’action. Lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, cette règle offre une manière commune de désaccord sans perdre l’élan. Elle transforme la migration cloud comme changement contrôlé d’une activité vivante en la planification de migration d’Arcadia comme progrès réversible, plutôt qu’en promesse abstraite.
Le véritable périmètre de la décision
La lecture pratique de la migration cloud comme changement contrôlé d’une activité vivante commence par cette observation : Migrer est une suite de décisions de risque, pas un événement d’infrastructure unique. Dans la section « Le véritable périmètre de la décision », elle compte parce que quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. Les preuves à examiner sont dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables ; sans elles, l’équipe peut confondre une explication séduisante avec une explication fiable. Un geste opérationnel utile consiste à répéter la reprise avant de demander à la production de faire confiance à la migration. Cela donne à une séquence de découverte, fonctionnement parallèle, bascule et apprentissage une limite visible, rend possible confiance dans la reprise et minutes d’impact client par phase et permet de revenir sur la conclusion lorsque la date de bascule prenne le pas sur la continuité de service.
Un système devient concret lorsqu’il est confronté à une situation comme une entreprise avec un système legacy critique et peu de tolérance à la panne. Dans ce cas, Les cartes de dépendances transforment la surprise en question que l’on peut répéter. L’équipe doit donc demander quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer avant de choisir un outil, un modèle ou une réunion. une séquence de découverte, fonctionnement parallèle, bascule et apprentissage compte parce qu’il transforme une ambition vague en séquence inspectable. L’action recommandée est de répéter la reprise avant de demander à la production de faire confiance à la migration puis de comparer le résultat avec dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. Si le résultat ne peut pas être expliqué, le problème n’est pas seulement l’exécution : il se peut que la date de bascule prenne le pas sur la continuité de service.
La couche de preuves change la qualité de la décision. Ici, dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables doit être considérée comme une matière à relire, et non comme une décoration autour d’une réponse déjà décidée. Le fonctionnement parallèle fournit des preuves, mais crée une charge temporaire de cohérence. Une équipe attentive consigne ce qu’elle attendait, ce qu’elle a observé et ce qui reste ouvert. Elle utilise ensuite confiance dans la reprise et minutes d’impact client par phase comme signal d’apprentissage, pas comme badge. C’est essentiel lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, car les contraintes locales peuvent révéler des hypothèses seulement plausibles.
Mettre en œuvre ne signifie pas courir du concept au logiciel. Cela signifie choisir une action bornée : répéter la reprise avant de demander à la production de faire confiance à la migration. La raison est simple : une séquence de découverte, fonctionnement parallèle, bascule et apprentissage ne peut être fiable que si chaque transition possède un responsable et une condition visible. Le retour arrière n’est crédible que s’il est plus rapide que l’improvisation. En pratique, l’équipe doit préserver un petit point de revue avant d’élargir le périmètre. Cette revue demande quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, inspecte dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables et note si confiance dans la reprise et minutes d’impact client par phase a changé. Sinon, la date de bascule prenne le pas sur la continuité de service ne sera découvert qu’une fois le changement coûteux.
Le contre-argument mérite une écoute honnête. Une équipe peut dire que la migration cloud comme changement contrôlé d’une activité vivante est trop nuancé pour une méthode répétable, ou que documenter ralentit le travail. La réponse n’est pas de supprimer la structure, mais de la garder proportionnelle à la conséquence. L’observabilité doit dire si l’activité reste saine, pas seulement si les serveurs répondent. La version minimale comprend une question, un responsable, une source ou observation, une décision et un chemin de retour. Cela suffit pour rendre la planification de migration d’Arcadia comme progrès réversible réelle tout en reconnaissant que la date de bascule prenne le pas sur la continuité de service. Cela protège aussi confiance dans la reprise et minutes d’impact client par phase contre la réduction à un chiffre séparé de la pratique.
La leçon durable de cette section est que une migration s’achève lorsque l’équipe sait exploiter le nouveau système un jour difficile. L’équipe peut la traduire en règle : partir de quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, rendre dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables disponible, organiser le travail avec une séquence de découverte, fonctionnement parallèle, bascule et apprentissage et relire confiance dans la reprise et minutes d’impact client par phase après l’action. Lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, cette règle offre une manière commune de désaccord sans perdre l’élan. Elle transforme la migration cloud comme changement contrôlé d’une activité vivante en la planification de migration d’Arcadia comme progrès réversible, plutôt qu’en promesse abstraite.
Preuves, sources et méthode
La lecture pratique de la migration cloud comme changement contrôlé d’une activité vivante commence par cette observation : Migrer est une suite de décisions de risque, pas un événement d’infrastructure unique. Dans la section « Preuves, sources et méthode », elle compte parce que quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. Les preuves à examiner sont dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables ; sans elles, l’équipe peut confondre une explication séduisante avec une explication fiable. Un geste opérationnel utile consiste à répéter la reprise avant de demander à la production de faire confiance à la migration. Cela donne à une séquence de découverte, fonctionnement parallèle, bascule et apprentissage une limite visible, rend possible confiance dans la reprise et minutes d’impact client par phase et permet de revenir sur la conclusion lorsque la date de bascule prenne le pas sur la continuité de service.
Un système devient concret lorsqu’il est confronté à une situation comme une entreprise avec un système legacy critique et peu de tolérance à la panne. Dans ce cas, Les cartes de dépendances transforment la surprise en question que l’on peut répéter. L’équipe doit donc demander quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer avant de choisir un outil, un modèle ou une réunion. une séquence de découverte, fonctionnement parallèle, bascule et apprentissage compte parce qu’il transforme une ambition vague en séquence inspectable. L’action recommandée est de répéter la reprise avant de demander à la production de faire confiance à la migration puis de comparer le résultat avec dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. Si le résultat ne peut pas être expliqué, le problème n’est pas seulement l’exécution : il se peut que la date de bascule prenne le pas sur la continuité de service.
La couche de preuves change la qualité de la décision. Ici, dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables doit être considérée comme une matière à relire, et non comme une décoration autour d’une réponse déjà décidée. Le fonctionnement parallèle fournit des preuves, mais crée une charge temporaire de cohérence. Une équipe attentive consigne ce qu’elle attendait, ce qu’elle a observé et ce qui reste ouvert. Elle utilise ensuite confiance dans la reprise et minutes d’impact client par phase comme signal d’apprentissage, pas comme badge. C’est essentiel lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, car les contraintes locales peuvent révéler des hypothèses seulement plausibles.
Mettre en œuvre ne signifie pas courir du concept au logiciel. Cela signifie choisir une action bornée : répéter la reprise avant de demander à la production de faire confiance à la migration. La raison est simple : une séquence de découverte, fonctionnement parallèle, bascule et apprentissage ne peut être fiable que si chaque transition possède un responsable et une condition visible. Le retour arrière n’est crédible que s’il est plus rapide que l’improvisation. En pratique, l’équipe doit préserver un petit point de revue avant d’élargir le périmètre. Cette revue demande quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, inspecte dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables et note si confiance dans la reprise et minutes d’impact client par phase a changé. Sinon, la date de bascule prenne le pas sur la continuité de service ne sera découvert qu’une fois le changement coûteux.
Le contre-argument mérite une écoute honnête. Une équipe peut dire que la migration cloud comme changement contrôlé d’une activité vivante est trop nuancé pour une méthode répétable, ou que documenter ralentit le travail. La réponse n’est pas de supprimer la structure, mais de la garder proportionnelle à la conséquence. L’observabilité doit dire si l’activité reste saine, pas seulement si les serveurs répondent. La version minimale comprend une question, un responsable, une source ou observation, une décision et un chemin de retour. Cela suffit pour rendre la planification de migration d’Arcadia comme progrès réversible réelle tout en reconnaissant que la date de bascule prenne le pas sur la continuité de service. Cela protège aussi confiance dans la reprise et minutes d’impact client par phase contre la réduction à un chiffre séparé de la pratique.
La leçon durable de cette section est que une migration s’achève lorsque l’équipe sait exploiter le nouveau système un jour difficile. L’équipe peut la traduire en règle : partir de quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, rendre dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables disponible, organiser le travail avec une séquence de découverte, fonctionnement parallèle, bascule et apprentissage et relire confiance dans la reprise et minutes d’impact client par phase après l’action. Lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, cette règle offre une manière commune de désaccord sans perdre l’élan. Elle transforme la migration cloud comme changement contrôlé d’une activité vivante en la planification de migration d’Arcadia comme progrès réversible, plutôt qu’en promesse abstraite.
Architecture et limites opérationnelles
La lecture pratique de la migration cloud comme changement contrôlé d’une activité vivante commence par cette observation : Migrer est une suite de décisions de risque, pas un événement d’infrastructure unique. Dans la section « Architecture et limites opérationnelles », elle compte parce que quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. Les preuves à examiner sont dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables ; sans elles, l’équipe peut confondre une explication séduisante avec une explication fiable. Un geste opérationnel utile consiste à répéter la reprise avant de demander à la production de faire confiance à la migration. Cela donne à une séquence de découverte, fonctionnement parallèle, bascule et apprentissage une limite visible, rend possible confiance dans la reprise et minutes d’impact client par phase et permet de revenir sur la conclusion lorsque la date de bascule prenne le pas sur la continuité de service.
Un système devient concret lorsqu’il est confronté à une situation comme une entreprise avec un système legacy critique et peu de tolérance à la panne. Dans ce cas, Les cartes de dépendances transforment la surprise en question que l’on peut répéter. L’équipe doit donc demander quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer avant de choisir un outil, un modèle ou une réunion. une séquence de découverte, fonctionnement parallèle, bascule et apprentissage compte parce qu’il transforme une ambition vague en séquence inspectable. L’action recommandée est de répéter la reprise avant de demander à la production de faire confiance à la migration puis de comparer le résultat avec dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. Si le résultat ne peut pas être expliqué, le problème n’est pas seulement l’exécution : il se peut que la date de bascule prenne le pas sur la continuité de service.
La couche de preuves change la qualité de la décision. Ici, dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables doit être considérée comme une matière à relire, et non comme une décoration autour d’une réponse déjà décidée. Le fonctionnement parallèle fournit des preuves, mais crée une charge temporaire de cohérence. Une équipe attentive consigne ce qu’elle attendait, ce qu’elle a observé et ce qui reste ouvert. Elle utilise ensuite confiance dans la reprise et minutes d’impact client par phase comme signal d’apprentissage, pas comme badge. C’est essentiel lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, car les contraintes locales peuvent révéler des hypothèses seulement plausibles.
Mettre en œuvre ne signifie pas courir du concept au logiciel. Cela signifie choisir une action bornée : répéter la reprise avant de demander à la production de faire confiance à la migration. La raison est simple : une séquence de découverte, fonctionnement parallèle, bascule et apprentissage ne peut être fiable que si chaque transition possède un responsable et une condition visible. Le retour arrière n’est crédible que s’il est plus rapide que l’improvisation. En pratique, l’équipe doit préserver un petit point de revue avant d’élargir le périmètre. Cette revue demande quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, inspecte dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables et note si confiance dans la reprise et minutes d’impact client par phase a changé. Sinon, la date de bascule prenne le pas sur la continuité de service ne sera découvert qu’une fois le changement coûteux.
Le contre-argument mérite une écoute honnête. Une équipe peut dire que la migration cloud comme changement contrôlé d’une activité vivante est trop nuancé pour une méthode répétable, ou que documenter ralentit le travail. La réponse n’est pas de supprimer la structure, mais de la garder proportionnelle à la conséquence. L’observabilité doit dire si l’activité reste saine, pas seulement si les serveurs répondent. La version minimale comprend une question, un responsable, une source ou observation, une décision et un chemin de retour. Cela suffit pour rendre la planification de migration d’Arcadia comme progrès réversible réelle tout en reconnaissant que la date de bascule prenne le pas sur la continuité de service. Cela protège aussi confiance dans la reprise et minutes d’impact client par phase contre la réduction à un chiffre séparé de la pratique.
La leçon durable de cette section est que une migration s’achève lorsque l’équipe sait exploiter le nouveau système un jour difficile. L’équipe peut la traduire en règle : partir de quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, rendre dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables disponible, organiser le travail avec une séquence de découverte, fonctionnement parallèle, bascule et apprentissage et relire confiance dans la reprise et minutes d’impact client par phase après l’action. Lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, cette règle offre une manière commune de désaccord sans perdre l’élan. Elle transforme la migration cloud comme changement contrôlé d’une activité vivante en la planification de migration d’Arcadia comme progrès réversible, plutôt qu’en promesse abstraite.
Du critère à la pratique
La lecture pratique de la migration cloud comme changement contrôlé d’une activité vivante commence par cette observation : Migrer est une suite de décisions de risque, pas un événement d’infrastructure unique. Dans la section « Du critère à la pratique », elle compte parce que quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. Les preuves à examiner sont dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables ; sans elles, l’équipe peut confondre une explication séduisante avec une explication fiable. Un geste opérationnel utile consiste à répéter la reprise avant de demander à la production de faire confiance à la migration. Cela donne à une séquence de découverte, fonctionnement parallèle, bascule et apprentissage une limite visible, rend possible confiance dans la reprise et minutes d’impact client par phase et permet de revenir sur la conclusion lorsque la date de bascule prenne le pas sur la continuité de service.
Un système devient concret lorsqu’il est confronté à une situation comme une entreprise avec un système legacy critique et peu de tolérance à la panne. Dans ce cas, Les cartes de dépendances transforment la surprise en question que l’on peut répéter. L’équipe doit donc demander quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer avant de choisir un outil, un modèle ou une réunion. une séquence de découverte, fonctionnement parallèle, bascule et apprentissage compte parce qu’il transforme une ambition vague en séquence inspectable. L’action recommandée est de répéter la reprise avant de demander à la production de faire confiance à la migration puis de comparer le résultat avec dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. Si le résultat ne peut pas être expliqué, le problème n’est pas seulement l’exécution : il se peut que la date de bascule prenne le pas sur la continuité de service.
La couche de preuves change la qualité de la décision. Ici, dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables doit être considérée comme une matière à relire, et non comme une décoration autour d’une réponse déjà décidée. Le fonctionnement parallèle fournit des preuves, mais crée une charge temporaire de cohérence. Une équipe attentive consigne ce qu’elle attendait, ce qu’elle a observé et ce qui reste ouvert. Elle utilise ensuite confiance dans la reprise et minutes d’impact client par phase comme signal d’apprentissage, pas comme badge. C’est essentiel lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, car les contraintes locales peuvent révéler des hypothèses seulement plausibles.
Mettre en œuvre ne signifie pas courir du concept au logiciel. Cela signifie choisir une action bornée : répéter la reprise avant de demander à la production de faire confiance à la migration. La raison est simple : une séquence de découverte, fonctionnement parallèle, bascule et apprentissage ne peut être fiable que si chaque transition possède un responsable et une condition visible. Le retour arrière n’est crédible que s’il est plus rapide que l’improvisation. En pratique, l’équipe doit préserver un petit point de revue avant d’élargir le périmètre. Cette revue demande quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, inspecte dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables et note si confiance dans la reprise et minutes d’impact client par phase a changé. Sinon, la date de bascule prenne le pas sur la continuité de service ne sera découvert qu’une fois le changement coûteux.
Le contre-argument mérite une écoute honnête. Une équipe peut dire que la migration cloud comme changement contrôlé d’une activité vivante est trop nuancé pour une méthode répétable, ou que documenter ralentit le travail. La réponse n’est pas de supprimer la structure, mais de la garder proportionnelle à la conséquence. L’observabilité doit dire si l’activité reste saine, pas seulement si les serveurs répondent. La version minimale comprend une question, un responsable, une source ou observation, une décision et un chemin de retour. Cela suffit pour rendre la planification de migration d’Arcadia comme progrès réversible réelle tout en reconnaissant que la date de bascule prenne le pas sur la continuité de service. Cela protège aussi confiance dans la reprise et minutes d’impact client par phase contre la réduction à un chiffre séparé de la pratique.
La leçon durable de cette section est que une migration s’achève lorsque l’équipe sait exploiter le nouveau système un jour difficile. L’équipe peut la traduire en règle : partir de quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, rendre dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables disponible, organiser le travail avec une séquence de découverte, fonctionnement parallèle, bascule et apprentissage et relire confiance dans la reprise et minutes d’impact client par phase après l’action. Lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, cette règle offre une manière commune de désaccord sans perdre l’élan. Elle transforme la migration cloud comme changement contrôlé d’une activité vivante en la planification de migration d’Arcadia comme progrès réversible, plutôt qu’en promesse abstraite.
Mesurer pour apprendre
La lecture pratique de la migration cloud comme changement contrôlé d’une activité vivante commence par cette observation : Migrer est une suite de décisions de risque, pas un événement d’infrastructure unique. Dans la section « Mesurer pour apprendre », elle compte parce que quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. Les preuves à examiner sont dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables ; sans elles, l’équipe peut confondre une explication séduisante avec une explication fiable. Un geste opérationnel utile consiste à répéter la reprise avant de demander à la production de faire confiance à la migration. Cela donne à une séquence de découverte, fonctionnement parallèle, bascule et apprentissage une limite visible, rend possible confiance dans la reprise et minutes d’impact client par phase et permet de revenir sur la conclusion lorsque la date de bascule prenne le pas sur la continuité de service.
Un système devient concret lorsqu’il est confronté à une situation comme une entreprise avec un système legacy critique et peu de tolérance à la panne. Dans ce cas, Les cartes de dépendances transforment la surprise en question que l’on peut répéter. L’équipe doit donc demander quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer avant de choisir un outil, un modèle ou une réunion. une séquence de découverte, fonctionnement parallèle, bascule et apprentissage compte parce qu’il transforme une ambition vague en séquence inspectable. L’action recommandée est de répéter la reprise avant de demander à la production de faire confiance à la migration puis de comparer le résultat avec dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. Si le résultat ne peut pas être expliqué, le problème n’est pas seulement l’exécution : il se peut que la date de bascule prenne le pas sur la continuité de service.
La couche de preuves change la qualité de la décision. Ici, dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables doit être considérée comme une matière à relire, et non comme une décoration autour d’une réponse déjà décidée. Le fonctionnement parallèle fournit des preuves, mais crée une charge temporaire de cohérence. Une équipe attentive consigne ce qu’elle attendait, ce qu’elle a observé et ce qui reste ouvert. Elle utilise ensuite confiance dans la reprise et minutes d’impact client par phase comme signal d’apprentissage, pas comme badge. C’est essentiel lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, car les contraintes locales peuvent révéler des hypothèses seulement plausibles.
Mettre en œuvre ne signifie pas courir du concept au logiciel. Cela signifie choisir une action bornée : répéter la reprise avant de demander à la production de faire confiance à la migration. La raison est simple : une séquence de découverte, fonctionnement parallèle, bascule et apprentissage ne peut être fiable que si chaque transition possède un responsable et une condition visible. Le retour arrière n’est crédible que s’il est plus rapide que l’improvisation. En pratique, l’équipe doit préserver un petit point de revue avant d’élargir le périmètre. Cette revue demande quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, inspecte dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables et note si confiance dans la reprise et minutes d’impact client par phase a changé. Sinon, la date de bascule prenne le pas sur la continuité de service ne sera découvert qu’une fois le changement coûteux.
Le contre-argument mérite une écoute honnête. Une équipe peut dire que la migration cloud comme changement contrôlé d’une activité vivante est trop nuancé pour une méthode répétable, ou que documenter ralentit le travail. La réponse n’est pas de supprimer la structure, mais de la garder proportionnelle à la conséquence. L’observabilité doit dire si l’activité reste saine, pas seulement si les serveurs répondent. La version minimale comprend une question, un responsable, une source ou observation, une décision et un chemin de retour. Cela suffit pour rendre la planification de migration d’Arcadia comme progrès réversible réelle tout en reconnaissant que la date de bascule prenne le pas sur la continuité de service. Cela protège aussi confiance dans la reprise et minutes d’impact client par phase contre la réduction à un chiffre séparé de la pratique.
La leçon durable de cette section est que une migration s’achève lorsque l’équipe sait exploiter le nouveau système un jour difficile. L’équipe peut la traduire en règle : partir de quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, rendre dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables disponible, organiser le travail avec une séquence de découverte, fonctionnement parallèle, bascule et apprentissage et relire confiance dans la reprise et minutes d’impact client par phase après l’action. Lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, cette règle offre une manière commune de désaccord sans perdre l’élan. Elle transforme la migration cloud comme changement contrôlé d’une activité vivante en la planification de migration d’Arcadia comme progrès réversible, plutôt qu’en promesse abstraite.
- répéter la reprise avant de demander à la production de faire confiance à la migration
- confiance dans la reprise et minutes d’impact client par phase
- la date de bascule prenne le pas sur la continuité de service
- la planification de migration d’Arcadia comme progrès réversible
Le rôle du jugement humain
La lecture pratique de la migration cloud comme changement contrôlé d’une activité vivante commence par cette observation : Migrer est une suite de décisions de risque, pas un événement d’infrastructure unique. Dans la section « Le rôle du jugement humain », elle compte parce que quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. Les preuves à examiner sont dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables ; sans elles, l’équipe peut confondre une explication séduisante avec une explication fiable. Un geste opérationnel utile consiste à répéter la reprise avant de demander à la production de faire confiance à la migration. Cela donne à une séquence de découverte, fonctionnement parallèle, bascule et apprentissage une limite visible, rend possible confiance dans la reprise et minutes d’impact client par phase et permet de revenir sur la conclusion lorsque la date de bascule prenne le pas sur la continuité de service.
Un système devient concret lorsqu’il est confronté à une situation comme une entreprise avec un système legacy critique et peu de tolérance à la panne. Dans ce cas, Les cartes de dépendances transforment la surprise en question que l’on peut répéter. L’équipe doit donc demander quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer avant de choisir un outil, un modèle ou une réunion. une séquence de découverte, fonctionnement parallèle, bascule et apprentissage compte parce qu’il transforme une ambition vague en séquence inspectable. L’action recommandée est de répéter la reprise avant de demander à la production de faire confiance à la migration puis de comparer le résultat avec dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. Si le résultat ne peut pas être expliqué, le problème n’est pas seulement l’exécution : il se peut que la date de bascule prenne le pas sur la continuité de service.
La couche de preuves change la qualité de la décision. Ici, dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables doit être considérée comme une matière à relire, et non comme une décoration autour d’une réponse déjà décidée. Le fonctionnement parallèle fournit des preuves, mais crée une charge temporaire de cohérence. Une équipe attentive consigne ce qu’elle attendait, ce qu’elle a observé et ce qui reste ouvert. Elle utilise ensuite confiance dans la reprise et minutes d’impact client par phase comme signal d’apprentissage, pas comme badge. C’est essentiel lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, car les contraintes locales peuvent révéler des hypothèses seulement plausibles.
Mettre en œuvre ne signifie pas courir du concept au logiciel. Cela signifie choisir une action bornée : répéter la reprise avant de demander à la production de faire confiance à la migration. La raison est simple : une séquence de découverte, fonctionnement parallèle, bascule et apprentissage ne peut être fiable que si chaque transition possède un responsable et une condition visible. Le retour arrière n’est crédible que s’il est plus rapide que l’improvisation. En pratique, l’équipe doit préserver un petit point de revue avant d’élargir le périmètre. Cette revue demande quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, inspecte dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables et note si confiance dans la reprise et minutes d’impact client par phase a changé. Sinon, la date de bascule prenne le pas sur la continuité de service ne sera découvert qu’une fois le changement coûteux.
Le contre-argument mérite une écoute honnête. Une équipe peut dire que la migration cloud comme changement contrôlé d’une activité vivante est trop nuancé pour une méthode répétable, ou que documenter ralentit le travail. La réponse n’est pas de supprimer la structure, mais de la garder proportionnelle à la conséquence. L’observabilité doit dire si l’activité reste saine, pas seulement si les serveurs répondent. La version minimale comprend une question, un responsable, une source ou observation, une décision et un chemin de retour. Cela suffit pour rendre la planification de migration d’Arcadia comme progrès réversible réelle tout en reconnaissant que la date de bascule prenne le pas sur la continuité de service. Cela protège aussi confiance dans la reprise et minutes d’impact client par phase contre la réduction à un chiffre séparé de la pratique.
La leçon durable de cette section est que une migration s’achève lorsque l’équipe sait exploiter le nouveau système un jour difficile. L’équipe peut la traduire en règle : partir de quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, rendre dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables disponible, organiser le travail avec une séquence de découverte, fonctionnement parallèle, bascule et apprentissage et relire confiance dans la reprise et minutes d’impact client par phase après l’action. Lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, cette règle offre une manière commune de désaccord sans perdre l’élan. Elle transforme la migration cloud comme changement contrôlé d’une activité vivante en la planification de migration d’Arcadia comme progrès réversible, plutôt qu’en promesse abstraite.
Modes d’échec et reprise
La lecture pratique de la migration cloud comme changement contrôlé d’une activité vivante commence par cette observation : Migrer est une suite de décisions de risque, pas un événement d’infrastructure unique. Dans la section « Modes d’échec et reprise », elle compte parce que quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. Les preuves à examiner sont dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables ; sans elles, l’équipe peut confondre une explication séduisante avec une explication fiable. Un geste opérationnel utile consiste à répéter la reprise avant de demander à la production de faire confiance à la migration. Cela donne à une séquence de découverte, fonctionnement parallèle, bascule et apprentissage une limite visible, rend possible confiance dans la reprise et minutes d’impact client par phase et permet de revenir sur la conclusion lorsque la date de bascule prenne le pas sur la continuité de service.
Un système devient concret lorsqu’il est confronté à une situation comme une entreprise avec un système legacy critique et peu de tolérance à la panne. Dans ce cas, Les cartes de dépendances transforment la surprise en question que l’on peut répéter. L’équipe doit donc demander quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer avant de choisir un outil, un modèle ou une réunion. une séquence de découverte, fonctionnement parallèle, bascule et apprentissage compte parce qu’il transforme une ambition vague en séquence inspectable. L’action recommandée est de répéter la reprise avant de demander à la production de faire confiance à la migration puis de comparer le résultat avec dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. Si le résultat ne peut pas être expliqué, le problème n’est pas seulement l’exécution : il se peut que la date de bascule prenne le pas sur la continuité de service.
La couche de preuves change la qualité de la décision. Ici, dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables doit être considérée comme une matière à relire, et non comme une décoration autour d’une réponse déjà décidée. Le fonctionnement parallèle fournit des preuves, mais crée une charge temporaire de cohérence. Une équipe attentive consigne ce qu’elle attendait, ce qu’elle a observé et ce qui reste ouvert. Elle utilise ensuite confiance dans la reprise et minutes d’impact client par phase comme signal d’apprentissage, pas comme badge. C’est essentiel lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, car les contraintes locales peuvent révéler des hypothèses seulement plausibles.
Mettre en œuvre ne signifie pas courir du concept au logiciel. Cela signifie choisir une action bornée : répéter la reprise avant de demander à la production de faire confiance à la migration. La raison est simple : une séquence de découverte, fonctionnement parallèle, bascule et apprentissage ne peut être fiable que si chaque transition possède un responsable et une condition visible. Le retour arrière n’est crédible que s’il est plus rapide que l’improvisation. En pratique, l’équipe doit préserver un petit point de revue avant d’élargir le périmètre. Cette revue demande quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, inspecte dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables et note si confiance dans la reprise et minutes d’impact client par phase a changé. Sinon, la date de bascule prenne le pas sur la continuité de service ne sera découvert qu’une fois le changement coûteux.
Le contre-argument mérite une écoute honnête. Une équipe peut dire que la migration cloud comme changement contrôlé d’une activité vivante est trop nuancé pour une méthode répétable, ou que documenter ralentit le travail. La réponse n’est pas de supprimer la structure, mais de la garder proportionnelle à la conséquence. L’observabilité doit dire si l’activité reste saine, pas seulement si les serveurs répondent. La version minimale comprend une question, un responsable, une source ou observation, une décision et un chemin de retour. Cela suffit pour rendre la planification de migration d’Arcadia comme progrès réversible réelle tout en reconnaissant que la date de bascule prenne le pas sur la continuité de service. Cela protège aussi confiance dans la reprise et minutes d’impact client par phase contre la réduction à un chiffre séparé de la pratique.
La leçon durable de cette section est que une migration s’achève lorsque l’équipe sait exploiter le nouveau système un jour difficile. L’équipe peut la traduire en règle : partir de quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, rendre dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables disponible, organiser le travail avec une séquence de découverte, fonctionnement parallèle, bascule et apprentissage et relire confiance dans la reprise et minutes d’impact client par phase après l’action. Lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, cette règle offre une manière commune de désaccord sans perdre l’élan. Elle transforme la migration cloud comme changement contrôlé d’une activité vivante en la planification de migration d’Arcadia comme progrès réversible, plutôt qu’en promesse abstraite.
Concevoir pour des contextes différents
La lecture pratique de la migration cloud comme changement contrôlé d’une activité vivante commence par cette observation : Migrer est une suite de décisions de risque, pas un événement d’infrastructure unique. Dans la section « Concevoir pour des contextes différents », elle compte parce que quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. Les preuves à examiner sont dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables ; sans elles, l’équipe peut confondre une explication séduisante avec une explication fiable. Un geste opérationnel utile consiste à répéter la reprise avant de demander à la production de faire confiance à la migration. Cela donne à une séquence de découverte, fonctionnement parallèle, bascule et apprentissage une limite visible, rend possible confiance dans la reprise et minutes d’impact client par phase et permet de revenir sur la conclusion lorsque la date de bascule prenne le pas sur la continuité de service.
Un système devient concret lorsqu’il est confronté à une situation comme une entreprise avec un système legacy critique et peu de tolérance à la panne. Dans ce cas, Les cartes de dépendances transforment la surprise en question que l’on peut répéter. L’équipe doit donc demander quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer avant de choisir un outil, un modèle ou une réunion. une séquence de découverte, fonctionnement parallèle, bascule et apprentissage compte parce qu’il transforme une ambition vague en séquence inspectable. L’action recommandée est de répéter la reprise avant de demander à la production de faire confiance à la migration puis de comparer le résultat avec dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. Si le résultat ne peut pas être expliqué, le problème n’est pas seulement l’exécution : il se peut que la date de bascule prenne le pas sur la continuité de service.
La couche de preuves change la qualité de la décision. Ici, dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables doit être considérée comme une matière à relire, et non comme une décoration autour d’une réponse déjà décidée. Le fonctionnement parallèle fournit des preuves, mais crée une charge temporaire de cohérence. Une équipe attentive consigne ce qu’elle attendait, ce qu’elle a observé et ce qui reste ouvert. Elle utilise ensuite confiance dans la reprise et minutes d’impact client par phase comme signal d’apprentissage, pas comme badge. C’est essentiel lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, car les contraintes locales peuvent révéler des hypothèses seulement plausibles.
Mettre en œuvre ne signifie pas courir du concept au logiciel. Cela signifie choisir une action bornée : répéter la reprise avant de demander à la production de faire confiance à la migration. La raison est simple : une séquence de découverte, fonctionnement parallèle, bascule et apprentissage ne peut être fiable que si chaque transition possède un responsable et une condition visible. Le retour arrière n’est crédible que s’il est plus rapide que l’improvisation. En pratique, l’équipe doit préserver un petit point de revue avant d’élargir le périmètre. Cette revue demande quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, inspecte dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables et note si confiance dans la reprise et minutes d’impact client par phase a changé. Sinon, la date de bascule prenne le pas sur la continuité de service ne sera découvert qu’une fois le changement coûteux.
Le contre-argument mérite une écoute honnête. Une équipe peut dire que la migration cloud comme changement contrôlé d’une activité vivante est trop nuancé pour une méthode répétable, ou que documenter ralentit le travail. La réponse n’est pas de supprimer la structure, mais de la garder proportionnelle à la conséquence. L’observabilité doit dire si l’activité reste saine, pas seulement si les serveurs répondent. La version minimale comprend une question, un responsable, une source ou observation, une décision et un chemin de retour. Cela suffit pour rendre la planification de migration d’Arcadia comme progrès réversible réelle tout en reconnaissant que la date de bascule prenne le pas sur la continuité de service. Cela protège aussi confiance dans la reprise et minutes d’impact client par phase contre la réduction à un chiffre séparé de la pratique.
La leçon durable de cette section est que une migration s’achève lorsque l’équipe sait exploiter le nouveau système un jour difficile. L’équipe peut la traduire en règle : partir de quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, rendre dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables disponible, organiser le travail avec une séquence de découverte, fonctionnement parallèle, bascule et apprentissage et relire confiance dans la reprise et minutes d’impact client par phase après l’action. Lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, cette règle offre une manière commune de désaccord sans perdre l’élan. Elle transforme la migration cloud comme changement contrôlé d’une activité vivante en la planification de migration d’Arcadia comme progrès réversible, plutôt qu’en promesse abstraite.
Le regard d’Inferent / Arcadia
La lecture pratique de la migration cloud comme changement contrôlé d’une activité vivante commence par cette observation : Migrer est une suite de décisions de risque, pas un événement d’infrastructure unique. Dans la section « Le regard d’Inferent / Arcadia », elle compte parce que quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. Les preuves à examiner sont dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables ; sans elles, l’équipe peut confondre une explication séduisante avec une explication fiable. Un geste opérationnel utile consiste à répéter la reprise avant de demander à la production de faire confiance à la migration. Cela donne à une séquence de découverte, fonctionnement parallèle, bascule et apprentissage une limite visible, rend possible confiance dans la reprise et minutes d’impact client par phase et permet de revenir sur la conclusion lorsque la date de bascule prenne le pas sur la continuité de service.
Un système devient concret lorsqu’il est confronté à une situation comme une entreprise avec un système legacy critique et peu de tolérance à la panne. Dans ce cas, Les cartes de dépendances transforment la surprise en question que l’on peut répéter. L’équipe doit donc demander quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer avant de choisir un outil, un modèle ou une réunion. une séquence de découverte, fonctionnement parallèle, bascule et apprentissage compte parce qu’il transforme une ambition vague en séquence inspectable. L’action recommandée est de répéter la reprise avant de demander à la production de faire confiance à la migration puis de comparer le résultat avec dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. Si le résultat ne peut pas être expliqué, le problème n’est pas seulement l’exécution : il se peut que la date de bascule prenne le pas sur la continuité de service.
La couche de preuves change la qualité de la décision. Ici, dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables doit être considérée comme une matière à relire, et non comme une décoration autour d’une réponse déjà décidée. Le fonctionnement parallèle fournit des preuves, mais crée une charge temporaire de cohérence. Une équipe attentive consigne ce qu’elle attendait, ce qu’elle a observé et ce qui reste ouvert. Elle utilise ensuite confiance dans la reprise et minutes d’impact client par phase comme signal d’apprentissage, pas comme badge. C’est essentiel lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, car les contraintes locales peuvent révéler des hypothèses seulement plausibles.
Mettre en œuvre ne signifie pas courir du concept au logiciel. Cela signifie choisir une action bornée : répéter la reprise avant de demander à la production de faire confiance à la migration. La raison est simple : une séquence de découverte, fonctionnement parallèle, bascule et apprentissage ne peut être fiable que si chaque transition possède un responsable et une condition visible. Le retour arrière n’est crédible que s’il est plus rapide que l’improvisation. En pratique, l’équipe doit préserver un petit point de revue avant d’élargir le périmètre. Cette revue demande quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, inspecte dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables et note si confiance dans la reprise et minutes d’impact client par phase a changé. Sinon, la date de bascule prenne le pas sur la continuité de service ne sera découvert qu’une fois le changement coûteux.
Le contre-argument mérite une écoute honnête. Une équipe peut dire que la migration cloud comme changement contrôlé d’une activité vivante est trop nuancé pour une méthode répétable, ou que documenter ralentit le travail. La réponse n’est pas de supprimer la structure, mais de la garder proportionnelle à la conséquence. L’observabilité doit dire si l’activité reste saine, pas seulement si les serveurs répondent. La version minimale comprend une question, un responsable, une source ou observation, une décision et un chemin de retour. Cela suffit pour rendre la planification de migration d’Arcadia comme progrès réversible réelle tout en reconnaissant que la date de bascule prenne le pas sur la continuité de service. Cela protège aussi confiance dans la reprise et minutes d’impact client par phase contre la réduction à un chiffre séparé de la pratique.
La leçon durable de cette section est que une migration s’achève lorsque l’équipe sait exploiter le nouveau système un jour difficile. L’équipe peut la traduire en règle : partir de quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, rendre dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables disponible, organiser le travail avec une séquence de découverte, fonctionnement parallèle, bascule et apprentissage et relire confiance dans la reprise et minutes d’impact client par phase après l’action. Lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, cette règle offre une manière commune de désaccord sans perdre l’élan. Elle transforme la migration cloud comme changement contrôlé d’une activité vivante en la planification de migration d’Arcadia comme progrès réversible, plutôt qu’en promesse abstraite.
Une route de mise en œuvre réversible
La lecture pratique de la migration cloud comme changement contrôlé d’une activité vivante commence par cette observation : Migrer est une suite de décisions de risque, pas un événement d’infrastructure unique. Dans la section « Une route de mise en œuvre réversible », elle compte parce que quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. Les preuves à examiner sont dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables ; sans elles, l’équipe peut confondre une explication séduisante avec une explication fiable. Un geste opérationnel utile consiste à répéter la reprise avant de demander à la production de faire confiance à la migration. Cela donne à une séquence de découverte, fonctionnement parallèle, bascule et apprentissage une limite visible, rend possible confiance dans la reprise et minutes d’impact client par phase et permet de revenir sur la conclusion lorsque la date de bascule prenne le pas sur la continuité de service.
Un système devient concret lorsqu’il est confronté à une situation comme une entreprise avec un système legacy critique et peu de tolérance à la panne. Dans ce cas, Les cartes de dépendances transforment la surprise en question que l’on peut répéter. L’équipe doit donc demander quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer avant de choisir un outil, un modèle ou une réunion. une séquence de découverte, fonctionnement parallèle, bascule et apprentissage compte parce qu’il transforme une ambition vague en séquence inspectable. L’action recommandée est de répéter la reprise avant de demander à la production de faire confiance à la migration puis de comparer le résultat avec dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. Si le résultat ne peut pas être expliqué, le problème n’est pas seulement l’exécution : il se peut que la date de bascule prenne le pas sur la continuité de service.
La couche de preuves change la qualité de la décision. Ici, dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables doit être considérée comme une matière à relire, et non comme une décoration autour d’une réponse déjà décidée. Le fonctionnement parallèle fournit des preuves, mais crée une charge temporaire de cohérence. Une équipe attentive consigne ce qu’elle attendait, ce qu’elle a observé et ce qui reste ouvert. Elle utilise ensuite confiance dans la reprise et minutes d’impact client par phase comme signal d’apprentissage, pas comme badge. C’est essentiel lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, car les contraintes locales peuvent révéler des hypothèses seulement plausibles.
Mettre en œuvre ne signifie pas courir du concept au logiciel. Cela signifie choisir une action bornée : répéter la reprise avant de demander à la production de faire confiance à la migration. La raison est simple : une séquence de découverte, fonctionnement parallèle, bascule et apprentissage ne peut être fiable que si chaque transition possède un responsable et une condition visible. Le retour arrière n’est crédible que s’il est plus rapide que l’improvisation. En pratique, l’équipe doit préserver un petit point de revue avant d’élargir le périmètre. Cette revue demande quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, inspecte dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables et note si confiance dans la reprise et minutes d’impact client par phase a changé. Sinon, la date de bascule prenne le pas sur la continuité de service ne sera découvert qu’une fois le changement coûteux.
Le contre-argument mérite une écoute honnête. Une équipe peut dire que la migration cloud comme changement contrôlé d’une activité vivante est trop nuancé pour une méthode répétable, ou que documenter ralentit le travail. La réponse n’est pas de supprimer la structure, mais de la garder proportionnelle à la conséquence. L’observabilité doit dire si l’activité reste saine, pas seulement si les serveurs répondent. La version minimale comprend une question, un responsable, une source ou observation, une décision et un chemin de retour. Cela suffit pour rendre la planification de migration d’Arcadia comme progrès réversible réelle tout en reconnaissant que la date de bascule prenne le pas sur la continuité de service. Cela protège aussi confiance dans la reprise et minutes d’impact client par phase contre la réduction à un chiffre séparé de la pratique.
La leçon durable de cette section est que une migration s’achève lorsque l’équipe sait exploiter le nouveau système un jour difficile. L’équipe peut la traduire en règle : partir de quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, rendre dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables disponible, organiser le travail avec une séquence de découverte, fonctionnement parallèle, bascule et apprentissage et relire confiance dans la reprise et minutes d’impact client par phase après l’action. Lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, cette règle offre une manière commune de désaccord sans perdre l’élan. Elle transforme la migration cloud comme changement contrôlé d’une activité vivante en la planification de migration d’Arcadia comme progrès réversible, plutôt qu’en promesse abstraite.
Conclusion éditoriale
La lecture pratique de la migration cloud comme changement contrôlé d’une activité vivante commence par cette observation : Migrer est une suite de décisions de risque, pas un événement d’infrastructure unique. Dans la section « Conclusion éditoriale », elle compte parce que quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer. Les preuves à examiner sont dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables ; sans elles, l’équipe peut confondre une explication séduisante avec une explication fiable. Un geste opérationnel utile consiste à répéter la reprise avant de demander à la production de faire confiance à la migration. Cela donne à une séquence de découverte, fonctionnement parallèle, bascule et apprentissage une limite visible, rend possible confiance dans la reprise et minutes d’impact client par phase et permet de revenir sur la conclusion lorsque la date de bascule prenne le pas sur la continuité de service.
Un système devient concret lorsqu’il est confronté à une situation comme une entreprise avec un système legacy critique et peu de tolérance à la panne. Dans ce cas, Les cartes de dépendances transforment la surprise en question que l’on peut répéter. L’équipe doit donc demander quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer avant de choisir un outil, un modèle ou une réunion. une séquence de découverte, fonctionnement parallèle, bascule et apprentissage compte parce qu’il transforme une ambition vague en séquence inspectable. L’action recommandée est de répéter la reprise avant de demander à la production de faire confiance à la migration puis de comparer le résultat avec dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. Si le résultat ne peut pas être expliqué, le problème n’est pas seulement l’exécution : il se peut que la date de bascule prenne le pas sur la continuité de service.
La couche de preuves change la qualité de la décision. Ici, dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables doit être considérée comme une matière à relire, et non comme une décoration autour d’une réponse déjà décidée. Le fonctionnement parallèle fournit des preuves, mais crée une charge temporaire de cohérence. Une équipe attentive consigne ce qu’elle attendait, ce qu’elle a observé et ce qui reste ouvert. Elle utilise ensuite confiance dans la reprise et minutes d’impact client par phase comme signal d’apprentissage, pas comme badge. C’est essentiel lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, car les contraintes locales peuvent révéler des hypothèses seulement plausibles.
Mettre en œuvre ne signifie pas courir du concept au logiciel. Cela signifie choisir une action bornée : répéter la reprise avant de demander à la production de faire confiance à la migration. La raison est simple : une séquence de découverte, fonctionnement parallèle, bascule et apprentissage ne peut être fiable que si chaque transition possède un responsable et une condition visible. Le retour arrière n’est crédible que s’il est plus rapide que l’improvisation. En pratique, l’équipe doit préserver un petit point de revue avant d’élargir le périmètre. Cette revue demande quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, inspecte dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables et note si confiance dans la reprise et minutes d’impact client par phase a changé. Sinon, la date de bascule prenne le pas sur la continuité de service ne sera découvert qu’une fois le changement coûteux.
Le contre-argument mérite une écoute honnête. Une équipe peut dire que la migration cloud comme changement contrôlé d’une activité vivante est trop nuancé pour une méthode répétable, ou que documenter ralentit le travail. La réponse n’est pas de supprimer la structure, mais de la garder proportionnelle à la conséquence. L’observabilité doit dire si l’activité reste saine, pas seulement si les serveurs répondent. La version minimale comprend une question, un responsable, une source ou observation, une décision et un chemin de retour. Cela suffit pour rendre la planification de migration d’Arcadia comme progrès réversible réelle tout en reconnaissant que la date de bascule prenne le pas sur la continuité de service. Cela protège aussi confiance dans la reprise et minutes d’impact client par phase contre la réduction à un chiffre séparé de la pratique.
La leçon durable de cette section est que une migration s’achève lorsque l’équipe sait exploiter le nouveau système un jour difficile. L’équipe peut la traduire en règle : partir de quelle capacité peut migrer sans rendre la prochaine panne plus difficile à récupérer, rendre dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables disponible, organiser le travail avec une séquence de découverte, fonctionnement parallèle, bascule et apprentissage et relire confiance dans la reprise et minutes d’impact client par phase après l’action. Lorsque une entreprise avec un système legacy critique et peu de tolérance à la panne, cette règle offre une manière commune de désaccord sans perdre l’élan. Elle transforme la migration cloud comme changement contrôlé d’une activité vivante en la planification de migration d’Arcadia comme progrès réversible, plutôt qu’en promesse abstraite.
Prochaine passe de révision
répéter la reprise avant de demander à la production de faire confiance à la migration dépendances, flux de données, niveaux de service, retours arrière et préparation des responsables. A reviewer should verify confiance dans la reprise et minutes d’impact client par phase and ask whether la date de bascule prenne le pas sur la continuité de service remains plausible. la planification de migration d’Arcadia comme progrès réversible is ready for the next editorial pass when the claim, owner, source path and correction route are all visible.