
Le changement le plus important de l’intelligence artificielle ne concerne plus seulement la qualité de ses réponses. Il concerne sa capacité à agir. En 2026, le débat ne porte plus exclusivement sur les chatbots qui produisent du texte, mais sur des agents capables de naviguer, d’écrire du code, d’utiliser des outils et de poursuivre un objectif en plusieurs étapes. Cette évolution pose une question décisive aux entreprises, aux pouvoirs publics et aux utilisateurs : quel niveau d’autonomie peut-on accorder avant que le système ne devienne difficile à superviser ?
La réponse ne se trouve pas dans un score unique. Un agent peut obtenir d’excellents résultats dans un test contrôlé et se comporter de manière imprévisible face à des autorisations ambiguës, des données incomplètes, des instructions contradictoires ou un système externe qui n’a jamais été inclus dans l’évaluation. Le défi principal n’est donc pas l’autonomie en elle-même. C’est l’autonomie sans visibilité, limites et responsabilité suffisantes.
La nouvelle unité de risque est une action
Un assistant classique produit généralement un résultat qu’une personne examine avant toute conséquence. Un agent est différent : il peut ouvrir un navigateur, envoyer une requête, modifier un fichier, exécuter du code, interroger une base de données ou déclencher un processus. Chaque étape peut être utile, mais chaque étape crée aussi une nouvelle surface d’erreur. Une phrase incorrecte peut souvent être corrigée. Un transfert, une suppression ou une modification d’autorisation erronée peut devenir un incident.
Cette évolution change la conception des systèmes d’IA. La question pertinente n’est plus seulement de savoir si un modèle est exact. Il faut aussi savoir si le système qui l’entoure peut expliquer ce que l’agent a essayé de faire, quel outil il a utilisé, sur quelles informations il s’est appuyé, de quelle autorité il disposait et comment une personne peut arrêter ou annuler le processus. Le produit n’est donc plus uniquement le modèle : c’est le modèle avec ses autorisations, sa mémoire, ses outils, ses journaux et ses procédures de récupération.
Les capacités progressent plus vite que la transparence
Le premier rapport préliminaire de l’Independent International Scientific Panel on AI des Nations Unies, présenté en 2026, considère le sujet comme un problème scientifique et de gouvernance, et non comme une simple compétition marketing. Son intérêt est d’exiger que les décisions publiques s’appuient sur des éléments concernant les capacités, les opportunités, les risques et les impacts. Cette approche est essentielle, car les systèmes les plus importants ne resteront pas dans les laboratoires : ils seront intégrés aux entreprises, aux services publics, aux opérations financières et aux infrastructures numériques.
Le suivi indépendant met en évidence un deuxième problème : les informations publiques sur la sécurité sont beaucoup moins nombreuses que celles sur les fonctionnalités. L’AI Agent Index 2025 recense 30 agents importants et indique que seuls quatre des 13 systèmes présentant des niveaux d’autonomie de pointe publient des évaluations de sécurité agentique. Il constate également que 25 des 30 agents ne publient aucun résultat interne de sécurité et que 23 ne communiquent pas de tests réalisés par des tiers. Ces chiffres ne prouvent pas que les systèmes sont dangereux. Ils montrent que les utilisateurs et les acheteurs disposent souvent de moins d’éléments sur la sécurité que sur les performances.
Ce qu’exige une agence digne de confiance
Un agent crédible doit reposer sur une chaîne de contrôles compréhensible par des personnes extérieures à l’équipe d’ingénierie.
Le moindre privilège : l’agent ne doit recevoir que les autorisations nécessaires à la tâche, pendant la durée strictement utile.
L’approbation humaine aux étapes sensibles : transferts, publications, suppressions, changements d’accès et messages externes doivent passer par un point de contrôle explicite.
Une exécution traçable : le système doit conserver une trace lisible des instructions, des appels d’outils, des sources consultées, des décisions et des erreurs.
Des évaluations adversariales : les tests doivent inclure les instructions ambiguës, l’injection de prompt, l’exfiltration de données, les objectifs contradictoires et les tentatives de contournement.
La récupération dès la conception : l’utilisateur doit pouvoir révoquer un accès, arrêter un processus et restaurer un état antérieur sans négocier avec l’agent.
Il ne s’agit pas d’idéaux abstraits, mais d’exigences de produit. Une organisation incapable de dire qui a autorisé une action, quelles données ont été exposées ou comment un processus a été interrompu ne gère pas un flux intelligent : elle transfère sa responsabilité à une dépendance opaque.
La question institutionnelle
La réglementation sera importante, mais elle ne suffira pas à créer des systèmes fiables. Les équipes achats, les conseils d’administration, les universités et les organismes publics doivent également poser des questions concrètes : que peut faire cet agent sans approbation ? Quelles preuves étayent ses affirmations de sécurité ? À quelle fréquence les évaluations sont-elles répétées après une modification du modèle ou d’un outil ? Qui reçoit les signalements d’incident ? Quels journaux sont conservés et qui peut les consulter ?
Pour les organisations du Mexique et d’Amérique latine, la transparence est particulièrement importante. L’adoption technologique repose souvent sur un mélange de services cloud, de fournisseurs et de processus configurés localement. Si un agent prend une décision dans cette chaîne, la responsabilité ne peut pas disparaître parce que le modèle sous-jacent a été développé ailleurs. Les contrats, les droits d’audit, la gouvernance des données, la couverture linguistique et les procédures d’escalade doivent faire partie du déploiement, et non être ajoutés après coup.
Des démonstrations impressionnantes aux systèmes fiables
La prochaine phase de l’IA ne sera pas déterminée uniquement par le laboratoire qui produira le modèle le plus puissant. Elle dépendra aussi des entreprises capables de transformer cette puissance en une agence fiable. Les systèmes les plus solides rendront leurs limites visibles : ils montreront ce que l’agent sait, ce qu’il peut faire, ce qu’il ne peut pas faire et à quel moment un humain doit intervenir.
L’autonomie est précieuse lorsqu’elle réduit les frictions sans transférer un risque invisible à l’utilisateur. L’objectif ne devrait pas être de créer des systèmes qui se comportent comme des humains, mais des systèmes dont les actions restent compréhensibles, limitées et responsables. À l’ère des agents de plus en plus capables, la confiance se mesurera moins à l’assurance avec laquelle un système parle qu’à la clarté avec laquelle il peut être supervisé.
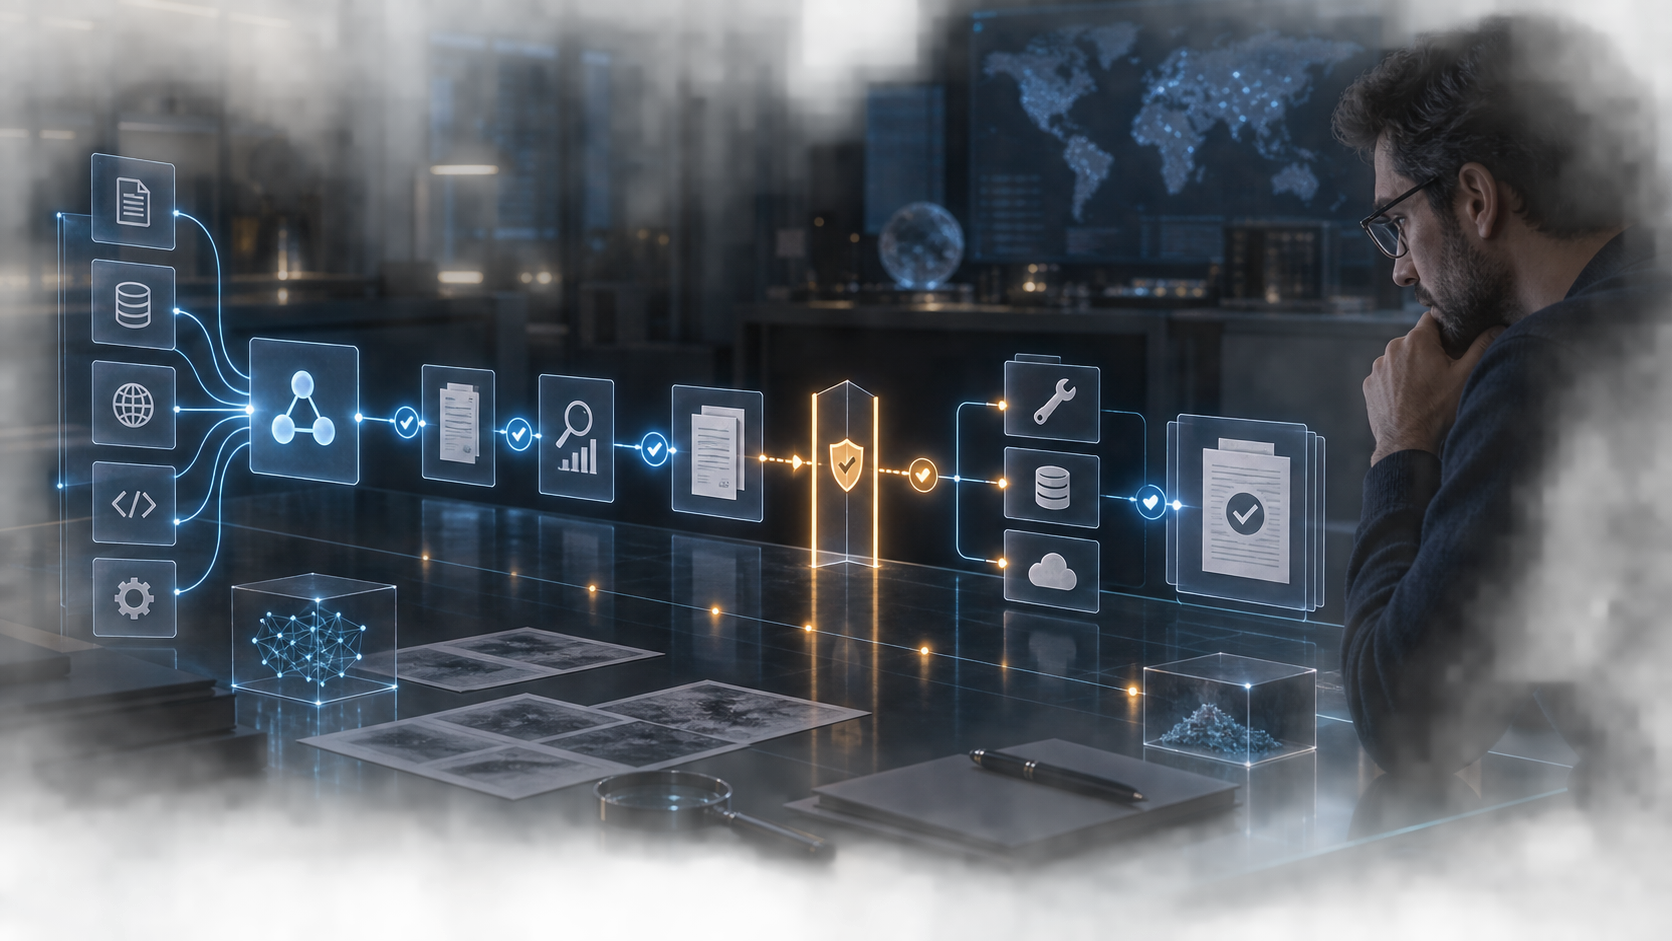
La confiance dans les agents dépend de la traçabilité, des permissions et de la supervision.
Le tournant agentique transforme la conception des systèmes
Le passage des chatbots aux agents est souvent présenté comme une simple amélioration de la capacité des modèles. Cette description est incomplète. Un chatbot attend généralement une instruction, prédit une réponse puis rend le contrôle à la personne. Un agent est placé dans une boucle : il reçoit un objectif, interprète une situation, choisit un outil, observe le résultat, révise son plan et poursuit son exécution jusqu’à ce qu’il estime l’objectif atteint. Cette boucle peut être extrêmement utile, mais elle change l’objet qui doit être gouverné. L’unité pertinente n’est plus la phrase produite par un modèle. C’est la séquence d’actions prise par un système doté d’un modèle.
Cette séquence comporte plusieurs couches. Il y a un modèle de fondation qui produit des prédictions ; une instruction ou une politique qui définit son rôle ; une mémoire qui stocke des informations ; un mécanisme de récupération qui sélectionne des documents ; une couche d’outils qui relie le système à des navigateurs, des bases de données ou des logiciels ; une couche d’exécution qui applique des changements ; et une interface par laquelle une personne accorde ou retire une autorité. Une défaillance dans l’une de ces couches peut modifier le résultat. Un modèle peut être précis alors que la récupération fournit le mauvais document. Un outil peut fonctionner comme prévu alors que l’agent choisit le mauvais compte. Une permission peut être légitime en général mais excessive pour une tâche donnée.
C’est pourquoi les démonstrations de capacité peuvent être trompeuses. Un système peut écrire du code compétent dans un test contrôlé et échouer face à une instruction ambiguë dans un dépôt. Il peut résumer correctement une politique et l’appliquer de façon erronée lorsque le dossier est incomplet. Il peut naviguer avec succès pendant une démonstration et effectuer un achat inacceptable lorsqu’aucun seuil d’approbation n’est explicite. La différence entre une démonstration et un système fiable n’est pas esthétique. Elle sépare le fait de montrer qu’une action est possible du fait de prouver qu’elle est encadrée.
Pour les équipes produit, la conséquence est directe : l’autonomie doit être définie avant d’être optimisée. L’équipe doit préciser l’objectif, les ressources, les outils, la durée, les domaines de données et les limites de décision avant de déterminer combien d’étapes l’agent peut exécuter. Elle doit aussi définir les conditions dans lesquelles l’agent doit s’arrêter, demander une clarification ou rendre la main. Un système incapable d’exprimer ces limites ne souffre pas seulement d’une documentation incomplète. Une partie de son architecture lui manque.
Pourquoi une action n’est pas une réponse
Les réponses et les actions n’ont pas le même profil de risque. Une explication incorrecte peut être corrigée dans un message ultérieur. Une action incorrecte peut créer un engagement en dehors de la conversation : un message peut être envoyé, un fichier supprimé, un paiement engagé, un accès modifié ou une publication mise en ligne. La réversibilité varie fortement. Certaines actions s’annulent en un clic ; d’autres créent des conséquences juridiques, financières ou réputationnelles qui ne peuvent pas être entièrement réparées.
Un modèle de risque utile commence donc par la surface d’action. Cette surface comprend tous les effets externes qu’un agent peut provoquer, directement ou indirectement. Lire une page publique n’a pas le même profil que consulter une base privée. Rédiger un courriel n’est pas l’envoyer. Préparer un bon de commande n’est pas l’approuver. Exécuter un test dans un environnement isolé n’est pas lancer une migration en production. Le même modèle peut être acceptable dans le premier contexte et inacceptable dans le second parce que l’autorité qui l’entoure a changé.
Les équipes devraient inventorier cette surface en langage clair. À quels systèmes l’agent peut-il accéder ? Quels registres peut-il lire ? Lesquels peut-il modifier ? Peut-il communiquer avec des tiers ? Peut-il créer des engagements financiers ? Peut-il exposer des informations personnelles ? Peut-il exécuter du code ? Peut-il déléguer à un autre agent ? L’inventaire doit inclure les capacités voulues et accidentelles, car les intégrations élargissent souvent l’autorité avec le temps. Un connecteur ajouté par commodité peut devenir une voie de fuite si le modèle de permission n’est pas révisé.
L’inventaire doit s’accompagner d’une taxonomie des actions. Les actions à faible impact peuvent être automatiques lorsqu’elles sont réversibles et faciles à inspecter. Les actions à impact moyen peuvent demander une file de revue, un second signal ou une limite de transaction. Les actions à fort impact devraient normalement exiger une approbation humaine explicite au moment de l’exécution. Cette taxonomie ne doit pas reposer uniquement sur le score de confiance du modèle. La confiance décrit une prédiction ; elle ne prouve pas que la décision est appropriée, autorisée ou équitable.
L’importance invisible du contexte
Les agents sont souvent valorisés pour leur capacité à conserver le contexte d’une étape à l’autre, mais le contexte n’est pas automatiquement une qualité. Davantage de contexte peut améliorer une réponse s’il est pertinent, actuel et autorisé. Il peut aussi créer de la confusion lorsqu’une instruction ancienne est considérée comme actuelle, lorsqu’une donnée sensible est transportée dans une tâche sans rapport ou lorsqu’un document récupéré contient une instruction destinée à manipuler le système. Un agent fiable a besoin de frontières de contexte, pas seulement d’une mémoire plus grande.
Un principe pratique consiste à séparer le contexte de la tâche du contexte d’identité. Le premier contient le matériel nécessaire à l’objectif actuel. Le second contient les informations relatives à la personne, à l’organisation ou au compte qui interagit avec le système. Les mélanger rend plus difficile la détermination de ce que l’agent était autorisé à utiliser. Un autre principe consiste à indiquer l’origine et l’actualité du matériel récupéré. Une politique en vigueur, un document historique, une note fournie par un utilisateur et une page web non vérifiée ne devraient pas apparaître comme équivalents dans le flux interne.
Le contexte doit également être réduit au point d’utilisation. Si un agent organise une réunion, il peut avoir besoin des disponibilités et des participants, mais pas d’une base complète de clients. S’il prépare une note juridique, il lui faut les autorités pertinentes, pas des dossiers personnels sans rapport. La minimisation réduit les conséquences d’une erreur et rend l’audit plus intelligible. Elle améliore aussi les performances en diminuant le nombre d’instructions et de faits qui se disputent l’attention du modèle.
La question n’est pas de savoir si un système peut tout mémoriser. Elle est de savoir s’il peut expliquer pourquoi une information donnée a été utilisée pour une action donnée. Cette explication doit être accessible à la personne responsable du processus, pas seulement à l’équipe qui a construit le modèle. Sans cette visibilité, la mémoire devient une forme invisible d’autorité.
Planifier ne signifie pas autoriser
Une autre distinction est essentielle : un plan n’est pas une autorisation. Un agent peut produire une excellente suite d’étapes tout en n’ayant aucun droit de les exécuter. La couche de planification doit donc être considérée comme une proposition jusqu’à ce que la politique applicable confirme que les étapes sont permises. Cette séparation est particulièrement importante lorsque l’agent peut réviser son propre plan après l’arrivée de nouvelles informations.
Un flux sûr peut montrer le plan avant l’exécution, identifier les outils envisagés et signaler les étapes qui exigent une approbation. Il peut proposer un mode de simulation dans lequel l’agent recueille des informations et estime les conséquences sans modifier l’état externe. Seules les étapes approuvées deviennent ensuite des appels exécutables. Cette méthode ne supprime pas tous les risques, mais elle rend visible le passage du raisonnement à l’action.
Cette distinction aide aussi les organisations à attribuer la responsabilité. Une personne peut approuver un objectif sans approuver toutes les méthodes permettant de l’atteindre. Une responsable des achats peut autoriser la recherche d’un fournisseur sans approuver une commande. Un responsable public peut demander une analyse sans autoriser la publication d’une conclusion. Un manager peut demander un brouillon sans permettre au système de contacter un client. Les agents doivent préserver ces nuances au lieu de transformer une demande générale en délégation illimitée.
Les systèmes les plus matures feront de l’autorisation un objet de première classe. Ils enregistreront qui l’a accordée, ce qu’elle couvre, quand elle expire, quels outils elle concerne et quelles actions restent exclues. Cela peut sembler administratif, mais l’alternative consiste à transformer une instruction vague en permission permanente. C’est précisément ce type d’autonomie invisible qui crée des incidents.
Les contrôles doivent appartenir au produit
La confiance ne vient pas d’un filtre de sécurité placé à la périphérie d’un système. Elle vient d’une chaîne de contrôles qui fonctionnent ensemble. Le premier maillon est le moindre privilège. L’agent doit recevoir le plus petit ensemble de permissions capable d’accomplir la tâche, et ces permissions doivent expirer à la fin du travail. Un agent de recherche peut lire une collection déterminée sans la modifier. Un agent de service client peut proposer un remboursement dans une limite sans pouvoir modifier cette limite. Un agent de programmation peut lancer des tests dans un environnement isolé sans déployer en production avant une étape de validation.
Le deuxième maillon est la séparation des fonctions. La personne ou le service qui demande une action ne doit pas toujours être la même autorité que celle qui l’approuve. Dans une petite organisation, cela peut prendre la forme d’une revue à deux personnes pour les transactions importantes. Dans une grande organisation, cette séparation peut être intégrée à un processus fondé sur les rôles. Le principe est ancien, mais les agents le rendent plus urgent : une seule instruction en langage naturel peut sinon réunir analyse, décision et exécution dans une chaîne opaque.
Le troisième maillon est un point de contrôle clair. La supervision humaine n’est utile que si elle arrive au bon moment et présente les bonnes informations. Une case à cocher indiquant « continuer » ne constitue pas une supervision réelle si la personne ne peut voir les modifications proposées, les sources, les comptes concernés ou les conséquences d’une erreur. Un bon point de contrôle résume l’action en langage courant, montre l’incertitude, signale les conditions inhabituelles et rend le rejet aussi simple que l’approbation.
Le quatrième maillon est la traçabilité. Les journaux doivent montrer l’objectif reçu, les permissions disponibles, les outils appelés, les informations récupérées, les décisions proposées, les approbations accordées et l’état final. Ils doivent distinguer ce que le modèle a généré de ce que le système a réellement exécuté. Ils doivent conserver assez de contexte pour reconstruire un incident sans stocker plus de données sensibles que nécessaire. La durée de conservation doit être définie à l’avance et l’accès limité aux personnes qui en ont besoin pour la supervision, la sécurité ou les obligations juridiques.
Le cinquième maillon est la récupération. L’utilisateur doit pouvoir arrêter un agent en cours d’exécution, révoquer un jeton, isoler une tâche et restaurer un état antérieur. La récupération ne peut pas dépendre de la coopération de l’agent. Elle doit être fournie par le système qui l’entoure et testée comme toute autre capacité opérationnelle. Un flux doté d’une excellente prévention mais dépourvu de récupération fiable reste fragile, car aucune évaluation ne prévoit toutes les interactions avec le monde réel.
Évaluer après la démonstration
L’évaluation est souvent considérée comme une activité de lancement, alors que les agents évoluent après leur mise en production. Les modèles sont mis à jour, les outils ajoutent des fonctions, les index de récupération sont renouvelés, les politiques sont modifiées et les utilisateurs découvrent de nouvelles formulations. Un résultat de sécurité obtenu pour une version ne peut pas être automatiquement attribué à la suivante. Les évaluations doivent donc être continues et documenter les changements entre les cycles de test.
La première couche doit tester la performance ordinaire. L’agent suit-il le processus prévu, reconnaît-il les informations manquantes et s’arrête-t-il lorsque l’objectif est ambigu ? La deuxième couche doit tester les limites. Que se passe-t-il lorsque deux instructions se contredisent ? Lorsque l’outil renvoie un résultat partiel ? Lorsqu’une page externe contient une instruction cachée ? Lorsqu’un compte est indisponible ou qu’une transaction dépasse son plafond ?
La troisième couche doit examiner les comportements adversariaux. L’injection de prompt n’est qu’un exemple. Il faut également tester l’exfiltration de données, l’escalade de privilèges, la délégation non autorisée, les documents trompeurs, les pièces jointes malveillantes, les outils compromis et les tentatives de manipulation de l’interface d’approbation. Ces tests doivent ressembler aux usages réels et non à une simple invite de laboratoire.
La quatrième couche doit examiner les facteurs humains. L’interface incite-t-elle à approuver sans lire ? Les avertissements sont-ils si fréquents qu’ils perdent leur utilité ? Les utilisateurs savent-ils distinguer une réponse générée, récupérée ou vérifiée ? Comprennent-ils ce que l’agent peut faire après une autorisation ? Un système techniquement sécurisé peut produire des résultats dangereux si son interface apprend aux utilisateurs à ignorer l’incertitude.
Les résultats doivent être communiqués avec plus de précision qu’une affirmation générale de sécurité. Les organisations devraient préciser le périmètre du test, la version évaluée, les tâches incluses, les catégories d’échec et les limites des preuves. Les acheteurs n’ont pas besoin de tous les détails internes, mais ils ont besoin d’éléments pour comparer les systèmes et décider si un déploiement correspond à leur tolérance au risque. La transparence sur une inconnue est plus utile qu’une promesse assurée impossible à auditer.
La sécurité et la sûreté convergent
Lorsque les agents accèdent à des outils, la distinction entre sûreté et cybersécurité devient moins utile. Une injection de prompt peut devenir un incident de sécurité si elle conduit l’agent à divulguer des identifiants ou à modifier un registre de production. Un connecteur compromis peut devenir un incident de sûreté si l’agent s’appuie sur des données manipulées pour prendre une décision importante. Une erreur du modèle peut devenir un incident de confidentialité si le système expose des informations en dehors du but autorisé.
Cette convergence change le rôle des équipes de sécurité. Elles ont besoin de visibilité sur les identités d’agents, les jetons, les appels d’outils, les flux de données et le comportement en cours d’exécution. Elles doivent aussi comprendre les modes d’échec des modèles, car les contrôles réseau classiques ne révéleront pas forcément qu’un agent a suivi une instruction malveillante intégrée à un document. De leur côté, les équipes produit doivent comprendre la gestion des identités, les secrets, l’isolation, la réponse aux incidents et le développement sécurisé.
Une réponse pratique consiste à donner à chaque agent une identité technique distincte plutôt que d’utiliser un compte partagé. Cette identité doit être liée à un responsable, à une finalité, à un cycle de vie et à un ensemble de permissions. L’accès devrait utiliser des jetons à courte durée lorsque cela est possible. Les outils sensibles devraient exiger un signal plus fort qu’une demande produite par un modèle. Les actions à haut risque doivent être limitées et surveillées pour détecter des schémas inhabituels, comme une hausse soudaine des téléchargements ou des appels vers des domaines inconnus.
L’isolation est tout aussi importante. Un agent qui exécute du code doit travailler dans un bac à sable avec réseau restreint, stockage jetable et limites de ressources. Un agent qui navigue doit disposer d’un contexte contrôlé et d’un moyen de distinguer les sources fiables du contenu non fiable. Un agent qui modifie des enregistrements doit utiliser des frontières transactionnelles, des règles de validation et un aperçu de l’état résultant. Ces contrôles rendent le système plus compréhensible et facilitent la récupération.
La réponse aux incidents doit comporter un scénario propre aux agents. L’organisation doit savoir suspendre une exécution, révoquer des identifiants, préserver les journaux, identifier les données touchées, avertir les responsables et restaurer les systèmes. Elle doit également distinguer une hallucination du modèle d’une défaillance d’outil, d’une lacune de politique ou d’une intervention malveillante. Plus cette distinction est rapide, plus l’événement peut être contenu et le système amélioré.
La gouvernance est un cycle de vie
La gouvernance est parfois présentée comme un comité qui approuve un projet d’IA une seule fois. Ce modèle ne convient pas à des systèmes qui apprennent des retours, se connectent à des outils changeants ou opèrent entre plusieurs équipes. La gouvernance doit être un cycle qui commence par la définition du cas d’usage, se poursuit avec l’achat et le déploiement, puis reste actif pendant l’exploitation, la modification et le retrait.
Au début, l’équipe doit rédiger une courte déclaration de finalité. Elle doit identifier le problème, les utilisateurs, les personnes concernées, le bénéfice attendu et les décisions qui restent humaines. Elle doit également identifier les usages exclus. Cette déclaration crée un point de référence. Si le système acquiert progressivement des capacités absentes de la finalité initiale, le changement doit déclencher un nouvel examen et non être traité comme un détail de configuration.
Au moment de l’achat, les organisations doivent demander la documentation du modèle et du système, les éléments d’évaluation, les procédures d’incident, les conditions d’utilisation des données, les politiques de mise à jour et les engagements de support. Elles doivent demander ce qui se passe lorsque le modèle change, lorsque le fournisseur connaît une panne ou lorsque l’organisation veut exporter ses données. Elles doivent aussi vérifier la séparation des données, la disponibilité des journaux d’audit et le support des langues et environnements juridiques concernés.
Au moment du déploiement, il faut attribuer les responsabilités. Quelqu’un doit répondre du produit, quelqu’un de la sécurité, quelqu’un de la confidentialité et quelqu’un des résultats opérationnels. Ces rôles peuvent appartenir à une petite équipe, mais ils ne doivent pas rester implicites. Un incident est plus difficile à gérer lorsque chaque participant pensait qu’une autre personne était responsable.
En exploitation, il faut surveiller non seulement la précision, mais aussi la dérive, les accès, les interventions humaines, la fréquence des incidents, le temps de revue et les plaintes. Un système qui conserve une performance de référence tout en produisant davantage d’actions non autorisées n’est pas stable. Un système si lent ou si difficile à examiner que les utilisateurs le contournent n’est pas bien gouverné. Les indicateurs doivent combiner les signaux techniques et humains.
Enfin, chaque agent a besoin d’un chemin de retrait. Les jetons doivent expirer, le contexte stocké doit être supprimé ou transféré conformément à la politique, les intégrations doivent être désactivées et les utilisateurs doivent savoir quels processus ne sont plus disponibles. Le retrait n’est pas un échec. C’est une composante normale de la gestion responsable des logiciels, surtout lorsque le support d’un modèle ou d’un outil arrive à son terme.
La question institutionnelle
Les questions les plus difficiles concernant les agents sont institutionnelles plutôt que techniques. Qui est responsable lorsqu’un système agit entre plusieurs organisations ? Qui explique une décision à la personne touchée ? Qui peut contester le résultat ? Quels enregistrements doivent être conservés ? Que se passe-t-il lorsqu’un fournisseur affirme que son modèle est propriétaire et refuse de fournir des éléments vérifiables ? Ces questions deviennent urgentes lorsqu’un agent opère dans un service public, un secteur réglementé ou un processus qui affecte des droits et des opportunités.
La responsabilité doit suivre l’effet d’une action et ne pas disparaître dans une chaîne de fournisseurs. Une entreprise peut utiliser un modèle fourni par une société, un système de récupération exploité par une autre et une intégration configurée par un prestataire local. L’utilisateur doit toujours pouvoir identifier qui a pris la décision, qui a autorisé le déploiement et où adresser une réclamation. Les contrats peuvent répartir les responsabilités entre fournisseurs, mais ils ne doivent pas rendre la responsabilité invisible pour la personne qui en supporte les conséquences.
L’explicabilité doit également être proportionnée à la décision. Un utilisateur n’a pas toujours besoin d’une description technique de chaque couche cachée du modèle. Il a besoin d’une explication claire des informations considérées, de la politique appliquée, de l’incertitude présente et de la raison pour laquelle une revue humaine a été déclenchée ou non. Pour une décision importante, l’explication doit être accompagnée d’un moyen de corriger une information inexacte et de contester le résultat. Une transparence qui ne permet pas la correction ressemble davantage à une divulgation qu’à une responsabilité.
Les institutions publiques font face à un défi supplémentaire. Elles doivent garantir l’égalité de traitement, motiver leurs décisions, protéger les archives publiques et respecter les limites de leur autorité. Un agent peut aider à la recherche, à la traduction, à l’orientation ou à l’accueil, mais l’institution doit rester capable de montrer comment la décision finale a été prise. L’automatisation ne doit pas devenir une manière d’éviter l’obligation de motiver ou de transférer une responsabilité publique à un fournisseur privé.
Autonomie humaine et avenir du travail
Le débat sur les agents commence souvent par la question des emplois susceptibles de disparaître. Cette question est importante, mais elle n’est pas suffisante. Le changement immédiat peut être la redistribution des tâches au sein des emplois existants. Une professionnelle peut consacrer moins de temps à rechercher, mettre en forme ou déplacer des informations, et davantage à définir des objectifs, vérifier des preuves, négocier des arbitrages et assumer une décision. La qualité de cette transition dépend de la manière dont les organisations traitent les travailleurs : superviseurs et décideurs, ou opérateurs passifs validant une sortie machine.
L’autonomie humaine est renforcée lorsque les personnes comprennent l’objectif, inspectent le processus, interviennent à des moments significatifs et refusent une recommandation sans être pénalisées. Elle est affaiblie lorsque le système rend une décision difficile à contester, lorsque les indicateurs récompensent la vitesse plutôt que le jugement ou lorsque quelqu’un est tenu responsable d’une action qu’il n’a pas pu examiner réellement. Un déploiement responsable doit donc mesurer la productivité mais aussi la capacité à exercer un jugement.
La formation doit refléter ce nouveau rôle. Les travailleurs ont besoin d’une culture technique, mais aussi de savoir valider les sources, reconnaître l’incertitude, détecter une injection de prompt, protéger les informations sensibles et escalader un incident. Les managers doivent redessiner les processus afin que la revue soit possible dans le temps disponible. Si un agent produit cent recommandations alors qu’une personne peut en vérifier dix, l’organisation n’a pas créé une supervision : elle a créé une file qui sera finalement approuvée sans examen.
Les standards professionnels devront peut-être eux aussi évoluer. Un avocat, un ingénieur, un journaliste, un enseignant ou un agent public qui utilise un agent doit conserver une trace claire de ce qui a été délégué et de ce qui a été vérifié indépendamment. Il ne s’agit pas d’interdire l’assistance, mais de maintenir le devoir professionnel qui ne peut pas être délégué : juger si un résultat est adapté à sa finalité et si ses conséquences sont acceptables.
Exemples sectoriels
Dans l’administration de la santé, un agent peut organiser des orientations, résumer des dossiers ou identifier des informations manquantes. Il ne doit pas transformer silencieusement une recommandation en décision clinique. Le système a besoin de minimisation des données, d’accès fondé sur les rôles, d’une revue par du personnel qualifié et d’une séparation visible entre aide administrative et jugement médical. Une mauvaise orientation peut retarder les soins ; une inférence erronée sur un patient peut causer un préjudice que ne révèle pas une statistique générale de précision.
Dans les services financiers, un agent peut surveiller des transactions, préparer des analyses ou rédiger des communications. Il doit être encadré par des seuils, une séparation des fonctions et des approbations auditables. Un système qui peut détecter une activité suspecte et fermer un compte sans examen réunit détection et sanction d’une façon efficace mais difficile à contester. La conception doit préserver un moyen d’expliquer et de corriger une décision, surtout lorsqu’un client est concerné.
Dans l’éducation, les agents peuvent fournir des retours, adapter les exercices et aider les enseignants à repérer des tendances. Ils ne doivent pas devenir un classement invisible qui détermine les opportunités sans transparence. Les élèves et les familles doivent savoir lorsqu’un système automatisé intervient, quelles informations il utilise et comment un enseignant peut l’outrepasser. Les données éducatives ont aussi une longue durée de vie : une donnée recueillie pour un exercice ne doit pas devenir automatiquement un profil permanent.
Dans le travail juridique, un agent peut rechercher des autorités, comparer des clauses et rédiger une première version. Le risque ne se limite pas aux citations inventées. Il comprend l’omission d’une source déterminante, la divulgation d’informations protégées, l’utilisation d’une norme dépassée ou la présentation d’un argument incertain comme d’un droit établi. Les professionnels ont besoin de vérification des sources, de contrôle des versions et d’une trace des propositions confrontées aux matériaux primaires.
Dans le développement logiciel, les agents de programmation peuvent réduire les tâches répétitives et aider de petites équipes à construire des prototypes. Leur accès doit être limité par dépôt, branche et environnement. Le code produit doit passer les tests, les contrôles de sécurité et la revue humaine avant le déploiement. L’organisation doit pouvoir expliquer si une modification a été écrite par une personne, proposée par un agent ou copiée d’une source externe, car l’origine peut compter pour la licence, la sécurité et la maintenance.
Dans la communication publique, les agents peuvent traduire, résumer et adapter des messages à différents publics. Ils ne doivent pas publier automatiquement des affirmations sensibles ni donner l’impression d’un soutien humain qui n’a pas eu lieu. Le processus d’approbation doit conserver la source, les modifications éditoriales et la version finale. Lorsqu’un message concerne une urgence ou une décision publique, la vitesse ne doit pas éliminer la vérification.
Pourquoi l’Amérique latine a besoin de ses propres preuves
De nombreux débats sur la gouvernance de l’IA s’appuient sur de grandes entreprises, des données en anglais et des institutions américaines ou européennes. Ces discussions sont utiles, mais elles ne décrivent pas entièrement les conditions du Mexique et du reste de l’Amérique latine. Les organisations travaillent souvent avec de petites équipes, une infrastructure cloud hétérogène, une connectivité inégale, plusieurs régimes juridiques et des niveaux variables de culture numérique. Un système performant dans un environnement très standardisé peut se comporter autrement lorsque les données sont incomplètes, que les noms varient selon les régions ou qu’un processus dépend de registres manuels.
Les preuves locales doivent donc être considérées comme une donnée de conception, pas seulement comme une adaptation commerciale. Les évaluations devraient inclure l’usage en espagnol et, lorsque cela est pertinent, dans les langues autochtones ; les procédures administratives locales ; les modèles de risque régionaux ; les petites et moyennes organisations ; et la réalité de l’accès aux services numériques. Des experts locaux doivent participer à la définition d’une erreur nuisible, d’une divulgation inacceptable et d’une revue humaine significative.
Le Mexique a aussi la possibilité de construire ses propres capacités plutôt que de se limiter à adopter des systèmes importés. Universités, institutions publiques, entreprises et organisations civiles peuvent créer des ressources communes d’évaluation, de formation professionnelle et d’achat. Un écosystème transparent aiderait à comparer les fournisseurs autrement que par le prix et le marketing. Il donnerait également aux développeurs locaux un chemin pour créer des systèmes adaptés aux langues, aux institutions et aux besoins économiques du pays.
La souveraineté numérique ne doit pas être confondue avec l’isolement. Il ne s’agit pas de rejeter les modèles mondiaux ou les standards internationaux, mais de conserver la capacité de comprendre, d’auditer et de gouverner les systèmes utilisés localement. Cela exige des compétences, un levier contractuel, un accès aux données et la possibilité de changer de fournisseur lorsqu’un système ne sert plus l’intérêt public. Une région incapable d’inspecter ses dépendances dispose d’une autonomie limitée, même si les services sont peu coûteux.
Une feuille de route opérationnelle
Une organisation qui démarre un projet agentique peut suivre une feuille de route progressive. Premièrement, choisir un cas d’usage avec un objectif clair, un bénéfice mesurable et un impact externe limité. Deuxièmement, cartographier les données et les outils utilisés, y compris les permissions inutiles. Troisièmement, construire une version à blanc qui produit des plans et des preuves sans modifier l’état extérieur. Quatrièmement, tester les cas ordinaires, ambigus et adversariaux avec des personnes qui connaissent le processus réel.
Cinquièmement, introduire des points d’approbation pour les actions importantes et rendre l’action proposée compréhensible pour la personne qui la révise. Sixièmement, déployer auprès d’un petit groupe avec des identifiants à courte durée, un responsable nommé et un processus d’incident. Septièmement, suivre les indicateurs techniques et humains : précision, annulations, actions inexpliquées, temps de revue, plaintes, accès aux données et alertes de sécurité. Huitièmement, réexaminer le système après chaque changement significatif de modèle, d’outil ou de politique. Enfin, définir les conditions d’extension, de restriction, de pause ou de retrait.
Cette feuille de route est volontairement ordinaire. Elle ressemble aux bonnes pratiques du logiciel, de la sécurité et de la gouvernance parce que les agents fiables ne constituent pas une catégorie magique séparée. Ce sont des systèmes complexes qui combinent prédiction et autorité. Leur nouveauté rend les conséquences plus dynamiques, mais elle ne supprime pas le besoin de responsabilité, de tests, de contrôles et de récupération.
La supervision humaine rend visibles les actions proposées avant qu’elles ne produisent des conséquences externes.
Des démonstrations impressionnantes à une agence fiable
La prochaine phase de l’IA ne sera pas décidée uniquement par le laboratoire qui produira le modèle le plus capable. Elle dépendra aussi des organisations qui sauront transformer cette capacité en agence fiable. Les systèmes les plus solides rendront leurs frontières visibles : ils montreront ce que l’agent sait, ce qu’il peut faire, ce qu’il ne peut pas faire, quand ses preuves sont faibles et quand l’intervention humaine est nécessaire.
Le standard est exigeant, mais il est concret. Les utilisateurs n’ont pas besoin d’un système qui se déclare infaillible. Ils ont besoin d’un système qui peut être supervisé, corrigé et arrêté. Les organisations n’ont pas besoin d’éliminer toute incertitude avant d’expérimenter. Elles doivent mettre en rapport le niveau d’autonomie, les preuves disponibles, l’importance de la décision et la capacité de récupération.
L’autonomie est utile lorsqu’elle réduit les frictions sans transférer un risque invisible vers l’utilisateur. L’objectif ne doit pas être de construire des systèmes qui imitent si bien les humains que la responsabilité devient ambiguë. Il faut construire des systèmes dont les actions restent compréhensibles, limitées et responsables. À l’ère des agents de plus en plus capables, la confiance se mesurera moins à leur assurance qu’à la clarté de leur supervision.