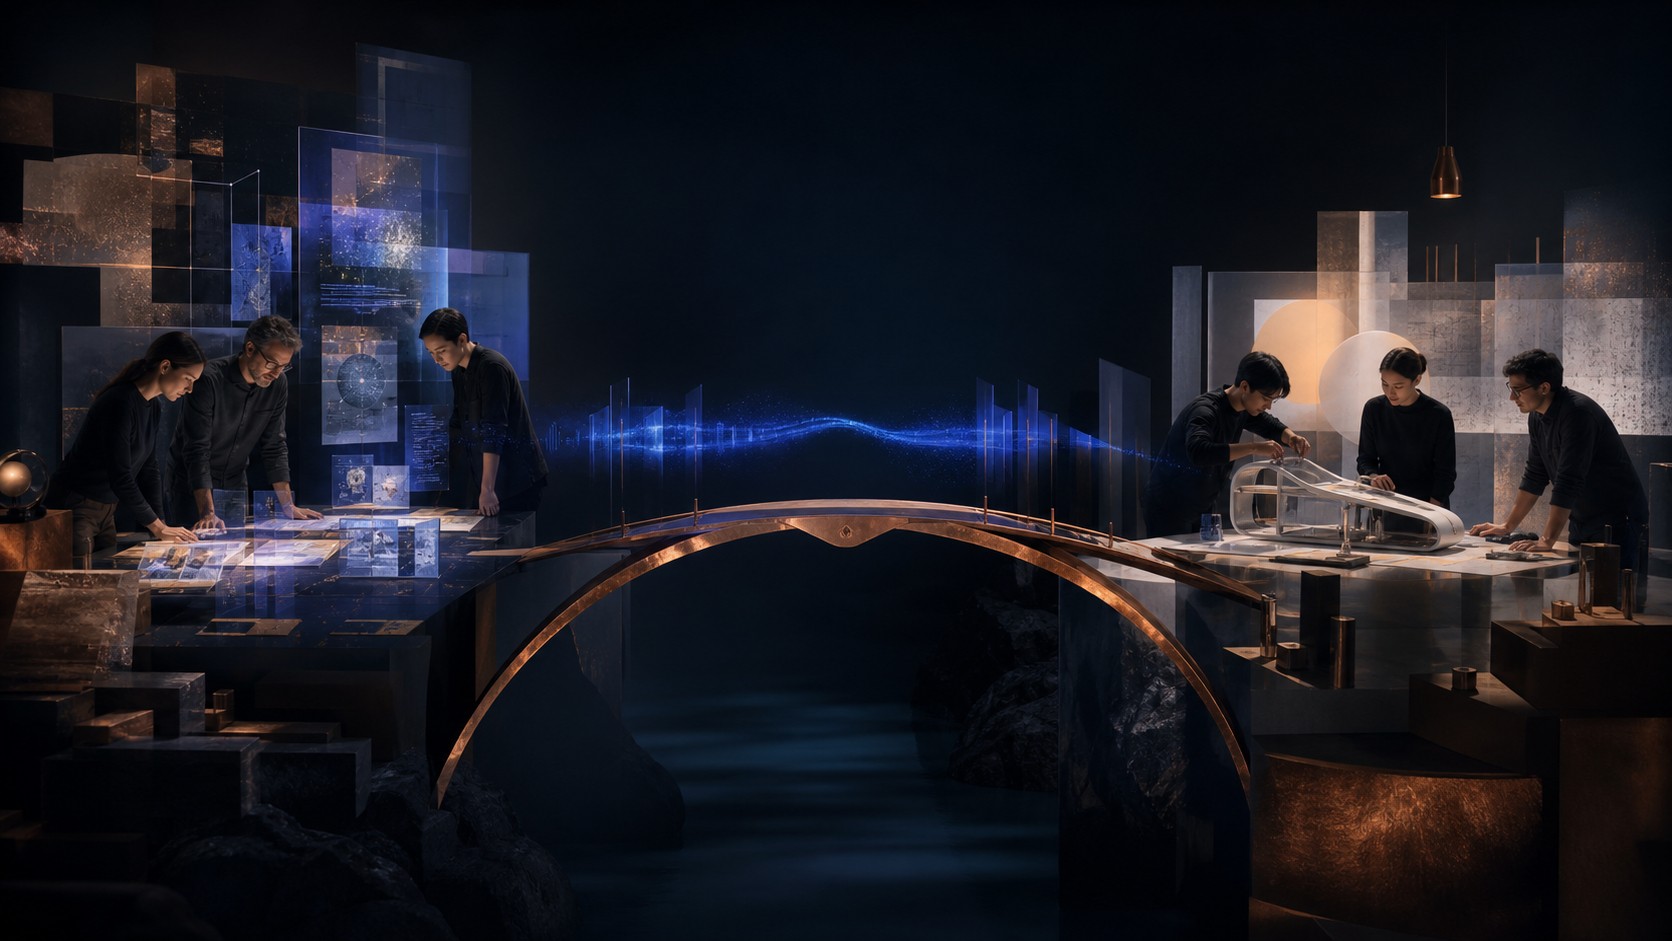

Resumen editorial. Un mapa de responsabilidades entre evidencia, producto, ingeniería y operación para un ecosistema digital coherente. Inferent y Arcadia como capas complementarias de un ecosistema.
qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad interfaces claras entre research, producto, ingeniería y servicio continuo.
Pregunta guía. qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. registros de decisiones, límites de producto, señales de entrega y resultados.
Nota metodológica. Este borrador de trabajo distingue evidencia, interpretación, acción y revisión para que el artículo pueda ser cuestionado antes de publicarse.
La tesis que guía el artículo
La lectura práctica de el stack operativo de una organización digital mediana comienza con esta observación: Un stack es un conjunto de responsabilidades antes que un conjunto de tecnologías. En la sección «La tesis que guía el artículo», importa porque qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. La evidencia que hay que mirar incluye registros de decisiones, límites de producto, señales de entrega y resultados; sin ella, el equipo puede confundir una explicación atractiva con una confiable. Un movimiento operativo útil es definir ownership por decisión y modo de falla, no por nombre de herramienta. Así, interfaces claras entre research, producto, ingeniería y servicio continuo adquiere un límite visible, se vuelve posible observar tiempo de pasar un insight verificado a capacidad confiable para clientes y se conserva la oportunidad de revisar la conclusión cuando el stack se vuelva lista de proveedores sin modelo operativo.
Un sistema se vuelve concreto cuando se prueba en una situación como una organización que coordina plataforma, servicio y research. En ese escenario, Las interfaces aclaran dónde puede fallar una entrega y quién la recupera. Por eso el equipo debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad antes de elegir herramienta, modelo o reunión. interfaces claras entre research, producto, ingeniería y servicio continuo importa porque convierte una ambición difusa en una secuencia inspeccionable. La acción recomendada es definir ownership por decisión y modo de falla, no por nombre de herramienta y después comparar el resultado con registros de decisiones, límites de producto, señales de entrega y resultados. Si el resultado no se puede explicar, el problema no es solo de ejecución: puede ser que el stack se vuelva lista de proveedores sin modelo operativo.
La capa de evidencia cambia la calidad de la decisión. Aquí, registros de decisiones, límites de producto, señales de entrega y resultados debe tratarse como material de revisión y no como decoración de una respuesta ya elegida. Research es parte de operaciones cuando las decisiones se repiten y la evidencia se acumula. Un equipo cuidadoso registra qué esperaba, qué observó y qué sigue abierto. Después utiliza tiempo de pasar un insight verificado a capacidad confiable para clientes como señal de aprendizaje y no como insignia. Esto importa especialmente cuando una organización que coordina plataforma, servicio y research, porque las restricciones locales pueden exponer supuestos razonables solo en apariencia.
Implementar no significa correr del concepto al software. Significa elegir una acción acotada: definir ownership por decisión y modo de falla, no por nombre de herramienta. La razón es sencilla: interfaces claras entre research, producto, ingeniería y servicio continuo solo merece confianza cuando cada transición tiene responsable y condición visible. La confiabilidad pertenece a la promesa de producto, no a una narrativa técnica aparte. En la práctica, el equipo debe proteger un punto pequeño de revisión antes de ampliar alcance. Esa revisión debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, inspeccionar registros de decisiones, límites de producto, señales de entrega y resultados y registrar si cambió tiempo de pasar un insight verificado a capacidad confiable para clientes. De lo contrario, el stack se vuelva lista de proveedores sin modelo operativo puede descubrirse cuando cambiar ya es costoso.
El contraargumento merece una escucha justa. Un equipo puede decir que el stack operativo de una organización digital mediana es demasiado matizado para un método repetible o que documentar ralentiza el trabajo. La respuesta no es quitar estructura, sino mantenerla proporcional a la consecuencia. Un ecosistema coherente facilita la siguiente capa sin ocultar sus límites. La versión mínima necesita una pregunta, un responsable, una fuente u observación, una decisión y un camino de regreso. Con eso basta para volver real Inferent y Arcadia como capas complementarias de un ecosistema mientras se reconoce que el stack se vuelva lista de proveedores sin modelo operativo. También protege tiempo de pasar un insight verificado a capacidad confiable para clientes de convertirse en un número separado de la práctica.
La lección durable de esta sección es que el mejor diagrama de arquitectura ayuda a decidir quién actúa después. El equipo puede traducirla en una regla de trabajo: partir de qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, hacer accesible registros de decisiones, límites de producto, señales de entrega y resultados, organizar el trabajo mediante interfaces claras entre research, producto, ingeniería y servicio continuo y revisar tiempo de pasar un insight verificado a capacidad confiable para clientes después de actuar. Cuando ocurre una organización que coordina plataforma, servicio y research, la regla ofrece una forma compartida de discrepar sin perder impulso. Convierte el stack operativo de una organización digital mediana en Inferent y Arcadia como capas complementarias de un ecosistema y no en otra promesa abstracta.
El alcance real de la decisión
La lectura práctica de el stack operativo de una organización digital mediana comienza con esta observación: Un stack es un conjunto de responsabilidades antes que un conjunto de tecnologías. En la sección «El alcance real de la decisión», importa porque qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. La evidencia que hay que mirar incluye registros de decisiones, límites de producto, señales de entrega y resultados; sin ella, el equipo puede confundir una explicación atractiva con una confiable. Un movimiento operativo útil es definir ownership por decisión y modo de falla, no por nombre de herramienta. Así, interfaces claras entre research, producto, ingeniería y servicio continuo adquiere un límite visible, se vuelve posible observar tiempo de pasar un insight verificado a capacidad confiable para clientes y se conserva la oportunidad de revisar la conclusión cuando el stack se vuelva lista de proveedores sin modelo operativo.
Un sistema se vuelve concreto cuando se prueba en una situación como una organización que coordina plataforma, servicio y research. En ese escenario, Las interfaces aclaran dónde puede fallar una entrega y quién la recupera. Por eso el equipo debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad antes de elegir herramienta, modelo o reunión. interfaces claras entre research, producto, ingeniería y servicio continuo importa porque convierte una ambición difusa en una secuencia inspeccionable. La acción recomendada es definir ownership por decisión y modo de falla, no por nombre de herramienta y después comparar el resultado con registros de decisiones, límites de producto, señales de entrega y resultados. Si el resultado no se puede explicar, el problema no es solo de ejecución: puede ser que el stack se vuelva lista de proveedores sin modelo operativo.
La capa de evidencia cambia la calidad de la decisión. Aquí, registros de decisiones, límites de producto, señales de entrega y resultados debe tratarse como material de revisión y no como decoración de una respuesta ya elegida. Research es parte de operaciones cuando las decisiones se repiten y la evidencia se acumula. Un equipo cuidadoso registra qué esperaba, qué observó y qué sigue abierto. Después utiliza tiempo de pasar un insight verificado a capacidad confiable para clientes como señal de aprendizaje y no como insignia. Esto importa especialmente cuando una organización que coordina plataforma, servicio y research, porque las restricciones locales pueden exponer supuestos razonables solo en apariencia.
Implementar no significa correr del concepto al software. Significa elegir una acción acotada: definir ownership por decisión y modo de falla, no por nombre de herramienta. La razón es sencilla: interfaces claras entre research, producto, ingeniería y servicio continuo solo merece confianza cuando cada transición tiene responsable y condición visible. La confiabilidad pertenece a la promesa de producto, no a una narrativa técnica aparte. En la práctica, el equipo debe proteger un punto pequeño de revisión antes de ampliar alcance. Esa revisión debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, inspeccionar registros de decisiones, límites de producto, señales de entrega y resultados y registrar si cambió tiempo de pasar un insight verificado a capacidad confiable para clientes. De lo contrario, el stack se vuelva lista de proveedores sin modelo operativo puede descubrirse cuando cambiar ya es costoso.
El contraargumento merece una escucha justa. Un equipo puede decir que el stack operativo de una organización digital mediana es demasiado matizado para un método repetible o que documentar ralentiza el trabajo. La respuesta no es quitar estructura, sino mantenerla proporcional a la consecuencia. Un ecosistema coherente facilita la siguiente capa sin ocultar sus límites. La versión mínima necesita una pregunta, un responsable, una fuente u observación, una decisión y un camino de regreso. Con eso basta para volver real Inferent y Arcadia como capas complementarias de un ecosistema mientras se reconoce que el stack se vuelva lista de proveedores sin modelo operativo. También protege tiempo de pasar un insight verificado a capacidad confiable para clientes de convertirse en un número separado de la práctica.
La lección durable de esta sección es que el mejor diagrama de arquitectura ayuda a decidir quién actúa después. El equipo puede traducirla en una regla de trabajo: partir de qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, hacer accesible registros de decisiones, límites de producto, señales de entrega y resultados, organizar el trabajo mediante interfaces claras entre research, producto, ingeniería y servicio continuo y revisar tiempo de pasar un insight verificado a capacidad confiable para clientes después de actuar. Cuando ocurre una organización que coordina plataforma, servicio y research, la regla ofrece una forma compartida de discrepar sin perder impulso. Convierte el stack operativo de una organización digital mediana en Inferent y Arcadia como capas complementarias de un ecosistema y no en otra promesa abstracta.
Evidencia, fuentes y método
La lectura práctica de el stack operativo de una organización digital mediana comienza con esta observación: Un stack es un conjunto de responsabilidades antes que un conjunto de tecnologías. En la sección «Evidencia, fuentes y método», importa porque qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. La evidencia que hay que mirar incluye registros de decisiones, límites de producto, señales de entrega y resultados; sin ella, el equipo puede confundir una explicación atractiva con una confiable. Un movimiento operativo útil es definir ownership por decisión y modo de falla, no por nombre de herramienta. Así, interfaces claras entre research, producto, ingeniería y servicio continuo adquiere un límite visible, se vuelve posible observar tiempo de pasar un insight verificado a capacidad confiable para clientes y se conserva la oportunidad de revisar la conclusión cuando el stack se vuelva lista de proveedores sin modelo operativo.
Un sistema se vuelve concreto cuando se prueba en una situación como una organización que coordina plataforma, servicio y research. En ese escenario, Las interfaces aclaran dónde puede fallar una entrega y quién la recupera. Por eso el equipo debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad antes de elegir herramienta, modelo o reunión. interfaces claras entre research, producto, ingeniería y servicio continuo importa porque convierte una ambición difusa en una secuencia inspeccionable. La acción recomendada es definir ownership por decisión y modo de falla, no por nombre de herramienta y después comparar el resultado con registros de decisiones, límites de producto, señales de entrega y resultados. Si el resultado no se puede explicar, el problema no es solo de ejecución: puede ser que el stack se vuelva lista de proveedores sin modelo operativo.
La capa de evidencia cambia la calidad de la decisión. Aquí, registros de decisiones, límites de producto, señales de entrega y resultados debe tratarse como material de revisión y no como decoración de una respuesta ya elegida. Research es parte de operaciones cuando las decisiones se repiten y la evidencia se acumula. Un equipo cuidadoso registra qué esperaba, qué observó y qué sigue abierto. Después utiliza tiempo de pasar un insight verificado a capacidad confiable para clientes como señal de aprendizaje y no como insignia. Esto importa especialmente cuando una organización que coordina plataforma, servicio y research, porque las restricciones locales pueden exponer supuestos razonables solo en apariencia.
Implementar no significa correr del concepto al software. Significa elegir una acción acotada: definir ownership por decisión y modo de falla, no por nombre de herramienta. La razón es sencilla: interfaces claras entre research, producto, ingeniería y servicio continuo solo merece confianza cuando cada transición tiene responsable y condición visible. La confiabilidad pertenece a la promesa de producto, no a una narrativa técnica aparte. En la práctica, el equipo debe proteger un punto pequeño de revisión antes de ampliar alcance. Esa revisión debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, inspeccionar registros de decisiones, límites de producto, señales de entrega y resultados y registrar si cambió tiempo de pasar un insight verificado a capacidad confiable para clientes. De lo contrario, el stack se vuelva lista de proveedores sin modelo operativo puede descubrirse cuando cambiar ya es costoso.
El contraargumento merece una escucha justa. Un equipo puede decir que el stack operativo de una organización digital mediana es demasiado matizado para un método repetible o que documentar ralentiza el trabajo. La respuesta no es quitar estructura, sino mantenerla proporcional a la consecuencia. Un ecosistema coherente facilita la siguiente capa sin ocultar sus límites. La versión mínima necesita una pregunta, un responsable, una fuente u observación, una decisión y un camino de regreso. Con eso basta para volver real Inferent y Arcadia como capas complementarias de un ecosistema mientras se reconoce que el stack se vuelva lista de proveedores sin modelo operativo. También protege tiempo de pasar un insight verificado a capacidad confiable para clientes de convertirse en un número separado de la práctica.
La lección durable de esta sección es que el mejor diagrama de arquitectura ayuda a decidir quién actúa después. El equipo puede traducirla en una regla de trabajo: partir de qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, hacer accesible registros de decisiones, límites de producto, señales de entrega y resultados, organizar el trabajo mediante interfaces claras entre research, producto, ingeniería y servicio continuo y revisar tiempo de pasar un insight verificado a capacidad confiable para clientes después de actuar. Cuando ocurre una organización que coordina plataforma, servicio y research, la regla ofrece una forma compartida de discrepar sin perder impulso. Convierte el stack operativo de una organización digital mediana en Inferent y Arcadia como capas complementarias de un ecosistema y no en otra promesa abstracta.
Arquitectura y límites operativos
La lectura práctica de el stack operativo de una organización digital mediana comienza con esta observación: Un stack es un conjunto de responsabilidades antes que un conjunto de tecnologías. En la sección «Arquitectura y límites operativos», importa porque qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. La evidencia que hay que mirar incluye registros de decisiones, límites de producto, señales de entrega y resultados; sin ella, el equipo puede confundir una explicación atractiva con una confiable. Un movimiento operativo útil es definir ownership por decisión y modo de falla, no por nombre de herramienta. Así, interfaces claras entre research, producto, ingeniería y servicio continuo adquiere un límite visible, se vuelve posible observar tiempo de pasar un insight verificado a capacidad confiable para clientes y se conserva la oportunidad de revisar la conclusión cuando el stack se vuelva lista de proveedores sin modelo operativo.
Un sistema se vuelve concreto cuando se prueba en una situación como una organización que coordina plataforma, servicio y research. En ese escenario, Las interfaces aclaran dónde puede fallar una entrega y quién la recupera. Por eso el equipo debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad antes de elegir herramienta, modelo o reunión. interfaces claras entre research, producto, ingeniería y servicio continuo importa porque convierte una ambición difusa en una secuencia inspeccionable. La acción recomendada es definir ownership por decisión y modo de falla, no por nombre de herramienta y después comparar el resultado con registros de decisiones, límites de producto, señales de entrega y resultados. Si el resultado no se puede explicar, el problema no es solo de ejecución: puede ser que el stack se vuelva lista de proveedores sin modelo operativo.
La capa de evidencia cambia la calidad de la decisión. Aquí, registros de decisiones, límites de producto, señales de entrega y resultados debe tratarse como material de revisión y no como decoración de una respuesta ya elegida. Research es parte de operaciones cuando las decisiones se repiten y la evidencia se acumula. Un equipo cuidadoso registra qué esperaba, qué observó y qué sigue abierto. Después utiliza tiempo de pasar un insight verificado a capacidad confiable para clientes como señal de aprendizaje y no como insignia. Esto importa especialmente cuando una organización que coordina plataforma, servicio y research, porque las restricciones locales pueden exponer supuestos razonables solo en apariencia.
Implementar no significa correr del concepto al software. Significa elegir una acción acotada: definir ownership por decisión y modo de falla, no por nombre de herramienta. La razón es sencilla: interfaces claras entre research, producto, ingeniería y servicio continuo solo merece confianza cuando cada transición tiene responsable y condición visible. La confiabilidad pertenece a la promesa de producto, no a una narrativa técnica aparte. En la práctica, el equipo debe proteger un punto pequeño de revisión antes de ampliar alcance. Esa revisión debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, inspeccionar registros de decisiones, límites de producto, señales de entrega y resultados y registrar si cambió tiempo de pasar un insight verificado a capacidad confiable para clientes. De lo contrario, el stack se vuelva lista de proveedores sin modelo operativo puede descubrirse cuando cambiar ya es costoso.
El contraargumento merece una escucha justa. Un equipo puede decir que el stack operativo de una organización digital mediana es demasiado matizado para un método repetible o que documentar ralentiza el trabajo. La respuesta no es quitar estructura, sino mantenerla proporcional a la consecuencia. Un ecosistema coherente facilita la siguiente capa sin ocultar sus límites. La versión mínima necesita una pregunta, un responsable, una fuente u observación, una decisión y un camino de regreso. Con eso basta para volver real Inferent y Arcadia como capas complementarias de un ecosistema mientras se reconoce que el stack se vuelva lista de proveedores sin modelo operativo. También protege tiempo de pasar un insight verificado a capacidad confiable para clientes de convertirse en un número separado de la práctica.
La lección durable de esta sección es que el mejor diagrama de arquitectura ayuda a decidir quién actúa después. El equipo puede traducirla en una regla de trabajo: partir de qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, hacer accesible registros de decisiones, límites de producto, señales de entrega y resultados, organizar el trabajo mediante interfaces claras entre research, producto, ingeniería y servicio continuo y revisar tiempo de pasar un insight verificado a capacidad confiable para clientes después de actuar. Cuando ocurre una organización que coordina plataforma, servicio y research, la regla ofrece una forma compartida de discrepar sin perder impulso. Convierte el stack operativo de una organización digital mediana en Inferent y Arcadia como capas complementarias de un ecosistema y no en otra promesa abstracta.
Del criterio a la práctica
La lectura práctica de el stack operativo de una organización digital mediana comienza con esta observación: Un stack es un conjunto de responsabilidades antes que un conjunto de tecnologías. En la sección «Del criterio a la práctica», importa porque qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. La evidencia que hay que mirar incluye registros de decisiones, límites de producto, señales de entrega y resultados; sin ella, el equipo puede confundir una explicación atractiva con una confiable. Un movimiento operativo útil es definir ownership por decisión y modo de falla, no por nombre de herramienta. Así, interfaces claras entre research, producto, ingeniería y servicio continuo adquiere un límite visible, se vuelve posible observar tiempo de pasar un insight verificado a capacidad confiable para clientes y se conserva la oportunidad de revisar la conclusión cuando el stack se vuelva lista de proveedores sin modelo operativo.
Un sistema se vuelve concreto cuando se prueba en una situación como una organización que coordina plataforma, servicio y research. En ese escenario, Las interfaces aclaran dónde puede fallar una entrega y quién la recupera. Por eso el equipo debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad antes de elegir herramienta, modelo o reunión. interfaces claras entre research, producto, ingeniería y servicio continuo importa porque convierte una ambición difusa en una secuencia inspeccionable. La acción recomendada es definir ownership por decisión y modo de falla, no por nombre de herramienta y después comparar el resultado con registros de decisiones, límites de producto, señales de entrega y resultados. Si el resultado no se puede explicar, el problema no es solo de ejecución: puede ser que el stack se vuelva lista de proveedores sin modelo operativo.
La capa de evidencia cambia la calidad de la decisión. Aquí, registros de decisiones, límites de producto, señales de entrega y resultados debe tratarse como material de revisión y no como decoración de una respuesta ya elegida. Research es parte de operaciones cuando las decisiones se repiten y la evidencia se acumula. Un equipo cuidadoso registra qué esperaba, qué observó y qué sigue abierto. Después utiliza tiempo de pasar un insight verificado a capacidad confiable para clientes como señal de aprendizaje y no como insignia. Esto importa especialmente cuando una organización que coordina plataforma, servicio y research, porque las restricciones locales pueden exponer supuestos razonables solo en apariencia.
Implementar no significa correr del concepto al software. Significa elegir una acción acotada: definir ownership por decisión y modo de falla, no por nombre de herramienta. La razón es sencilla: interfaces claras entre research, producto, ingeniería y servicio continuo solo merece confianza cuando cada transición tiene responsable y condición visible. La confiabilidad pertenece a la promesa de producto, no a una narrativa técnica aparte. En la práctica, el equipo debe proteger un punto pequeño de revisión antes de ampliar alcance. Esa revisión debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, inspeccionar registros de decisiones, límites de producto, señales de entrega y resultados y registrar si cambió tiempo de pasar un insight verificado a capacidad confiable para clientes. De lo contrario, el stack se vuelva lista de proveedores sin modelo operativo puede descubrirse cuando cambiar ya es costoso.
El contraargumento merece una escucha justa. Un equipo puede decir que el stack operativo de una organización digital mediana es demasiado matizado para un método repetible o que documentar ralentiza el trabajo. La respuesta no es quitar estructura, sino mantenerla proporcional a la consecuencia. Un ecosistema coherente facilita la siguiente capa sin ocultar sus límites. La versión mínima necesita una pregunta, un responsable, una fuente u observación, una decisión y un camino de regreso. Con eso basta para volver real Inferent y Arcadia como capas complementarias de un ecosistema mientras se reconoce que el stack se vuelva lista de proveedores sin modelo operativo. También protege tiempo de pasar un insight verificado a capacidad confiable para clientes de convertirse en un número separado de la práctica.
La lección durable de esta sección es que el mejor diagrama de arquitectura ayuda a decidir quién actúa después. El equipo puede traducirla en una regla de trabajo: partir de qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, hacer accesible registros de decisiones, límites de producto, señales de entrega y resultados, organizar el trabajo mediante interfaces claras entre research, producto, ingeniería y servicio continuo y revisar tiempo de pasar un insight verificado a capacidad confiable para clientes después de actuar. Cuando ocurre una organización que coordina plataforma, servicio y research, la regla ofrece una forma compartida de discrepar sin perder impulso. Convierte el stack operativo de una organización digital mediana en Inferent y Arcadia como capas complementarias de un ecosistema y no en otra promesa abstracta.
Medir para aprender
La lectura práctica de el stack operativo de una organización digital mediana comienza con esta observación: Un stack es un conjunto de responsabilidades antes que un conjunto de tecnologías. En la sección «Medir para aprender», importa porque qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. La evidencia que hay que mirar incluye registros de decisiones, límites de producto, señales de entrega y resultados; sin ella, el equipo puede confundir una explicación atractiva con una confiable. Un movimiento operativo útil es definir ownership por decisión y modo de falla, no por nombre de herramienta. Así, interfaces claras entre research, producto, ingeniería y servicio continuo adquiere un límite visible, se vuelve posible observar tiempo de pasar un insight verificado a capacidad confiable para clientes y se conserva la oportunidad de revisar la conclusión cuando el stack se vuelva lista de proveedores sin modelo operativo.
Un sistema se vuelve concreto cuando se prueba en una situación como una organización que coordina plataforma, servicio y research. En ese escenario, Las interfaces aclaran dónde puede fallar una entrega y quién la recupera. Por eso el equipo debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad antes de elegir herramienta, modelo o reunión. interfaces claras entre research, producto, ingeniería y servicio continuo importa porque convierte una ambición difusa en una secuencia inspeccionable. La acción recomendada es definir ownership por decisión y modo de falla, no por nombre de herramienta y después comparar el resultado con registros de decisiones, límites de producto, señales de entrega y resultados. Si el resultado no se puede explicar, el problema no es solo de ejecución: puede ser que el stack se vuelva lista de proveedores sin modelo operativo.
La capa de evidencia cambia la calidad de la decisión. Aquí, registros de decisiones, límites de producto, señales de entrega y resultados debe tratarse como material de revisión y no como decoración de una respuesta ya elegida. Research es parte de operaciones cuando las decisiones se repiten y la evidencia se acumula. Un equipo cuidadoso registra qué esperaba, qué observó y qué sigue abierto. Después utiliza tiempo de pasar un insight verificado a capacidad confiable para clientes como señal de aprendizaje y no como insignia. Esto importa especialmente cuando una organización que coordina plataforma, servicio y research, porque las restricciones locales pueden exponer supuestos razonables solo en apariencia.
Implementar no significa correr del concepto al software. Significa elegir una acción acotada: definir ownership por decisión y modo de falla, no por nombre de herramienta. La razón es sencilla: interfaces claras entre research, producto, ingeniería y servicio continuo solo merece confianza cuando cada transición tiene responsable y condición visible. La confiabilidad pertenece a la promesa de producto, no a una narrativa técnica aparte. En la práctica, el equipo debe proteger un punto pequeño de revisión antes de ampliar alcance. Esa revisión debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, inspeccionar registros de decisiones, límites de producto, señales de entrega y resultados y registrar si cambió tiempo de pasar un insight verificado a capacidad confiable para clientes. De lo contrario, el stack se vuelva lista de proveedores sin modelo operativo puede descubrirse cuando cambiar ya es costoso.
El contraargumento merece una escucha justa. Un equipo puede decir que el stack operativo de una organización digital mediana es demasiado matizado para un método repetible o que documentar ralentiza el trabajo. La respuesta no es quitar estructura, sino mantenerla proporcional a la consecuencia. Un ecosistema coherente facilita la siguiente capa sin ocultar sus límites. La versión mínima necesita una pregunta, un responsable, una fuente u observación, una decisión y un camino de regreso. Con eso basta para volver real Inferent y Arcadia como capas complementarias de un ecosistema mientras se reconoce que el stack se vuelva lista de proveedores sin modelo operativo. También protege tiempo de pasar un insight verificado a capacidad confiable para clientes de convertirse en un número separado de la práctica.
La lección durable de esta sección es que el mejor diagrama de arquitectura ayuda a decidir quién actúa después. El equipo puede traducirla en una regla de trabajo: partir de qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, hacer accesible registros de decisiones, límites de producto, señales de entrega y resultados, organizar el trabajo mediante interfaces claras entre research, producto, ingeniería y servicio continuo y revisar tiempo de pasar un insight verificado a capacidad confiable para clientes después de actuar. Cuando ocurre una organización que coordina plataforma, servicio y research, la regla ofrece una forma compartida de discrepar sin perder impulso. Convierte el stack operativo de una organización digital mediana en Inferent y Arcadia como capas complementarias de un ecosistema y no en otra promesa abstracta.
- definir ownership por decisión y modo de falla, no por nombre de herramienta
- tiempo de pasar un insight verificado a capacidad confiable para clientes
- el stack se vuelva lista de proveedores sin modelo operativo
- Inferent y Arcadia como capas complementarias de un ecosistema
El papel del criterio humano
La lectura práctica de el stack operativo de una organización digital mediana comienza con esta observación: Un stack es un conjunto de responsabilidades antes que un conjunto de tecnologías. En la sección «El papel del criterio humano», importa porque qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. La evidencia que hay que mirar incluye registros de decisiones, límites de producto, señales de entrega y resultados; sin ella, el equipo puede confundir una explicación atractiva con una confiable. Un movimiento operativo útil es definir ownership por decisión y modo de falla, no por nombre de herramienta. Así, interfaces claras entre research, producto, ingeniería y servicio continuo adquiere un límite visible, se vuelve posible observar tiempo de pasar un insight verificado a capacidad confiable para clientes y se conserva la oportunidad de revisar la conclusión cuando el stack se vuelva lista de proveedores sin modelo operativo.
Un sistema se vuelve concreto cuando se prueba en una situación como una organización que coordina plataforma, servicio y research. En ese escenario, Las interfaces aclaran dónde puede fallar una entrega y quién la recupera. Por eso el equipo debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad antes de elegir herramienta, modelo o reunión. interfaces claras entre research, producto, ingeniería y servicio continuo importa porque convierte una ambición difusa en una secuencia inspeccionable. La acción recomendada es definir ownership por decisión y modo de falla, no por nombre de herramienta y después comparar el resultado con registros de decisiones, límites de producto, señales de entrega y resultados. Si el resultado no se puede explicar, el problema no es solo de ejecución: puede ser que el stack se vuelva lista de proveedores sin modelo operativo.
La capa de evidencia cambia la calidad de la decisión. Aquí, registros de decisiones, límites de producto, señales de entrega y resultados debe tratarse como material de revisión y no como decoración de una respuesta ya elegida. Research es parte de operaciones cuando las decisiones se repiten y la evidencia se acumula. Un equipo cuidadoso registra qué esperaba, qué observó y qué sigue abierto. Después utiliza tiempo de pasar un insight verificado a capacidad confiable para clientes como señal de aprendizaje y no como insignia. Esto importa especialmente cuando una organización que coordina plataforma, servicio y research, porque las restricciones locales pueden exponer supuestos razonables solo en apariencia.
Implementar no significa correr del concepto al software. Significa elegir una acción acotada: definir ownership por decisión y modo de falla, no por nombre de herramienta. La razón es sencilla: interfaces claras entre research, producto, ingeniería y servicio continuo solo merece confianza cuando cada transición tiene responsable y condición visible. La confiabilidad pertenece a la promesa de producto, no a una narrativa técnica aparte. En la práctica, el equipo debe proteger un punto pequeño de revisión antes de ampliar alcance. Esa revisión debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, inspeccionar registros de decisiones, límites de producto, señales de entrega y resultados y registrar si cambió tiempo de pasar un insight verificado a capacidad confiable para clientes. De lo contrario, el stack se vuelva lista de proveedores sin modelo operativo puede descubrirse cuando cambiar ya es costoso.
El contraargumento merece una escucha justa. Un equipo puede decir que el stack operativo de una organización digital mediana es demasiado matizado para un método repetible o que documentar ralentiza el trabajo. La respuesta no es quitar estructura, sino mantenerla proporcional a la consecuencia. Un ecosistema coherente facilita la siguiente capa sin ocultar sus límites. La versión mínima necesita una pregunta, un responsable, una fuente u observación, una decisión y un camino de regreso. Con eso basta para volver real Inferent y Arcadia como capas complementarias de un ecosistema mientras se reconoce que el stack se vuelva lista de proveedores sin modelo operativo. También protege tiempo de pasar un insight verificado a capacidad confiable para clientes de convertirse en un número separado de la práctica.
La lección durable de esta sección es que el mejor diagrama de arquitectura ayuda a decidir quién actúa después. El equipo puede traducirla en una regla de trabajo: partir de qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, hacer accesible registros de decisiones, límites de producto, señales de entrega y resultados, organizar el trabajo mediante interfaces claras entre research, producto, ingeniería y servicio continuo y revisar tiempo de pasar un insight verificado a capacidad confiable para clientes después de actuar. Cuando ocurre una organización que coordina plataforma, servicio y research, la regla ofrece una forma compartida de discrepar sin perder impulso. Convierte el stack operativo de una organización digital mediana en Inferent y Arcadia como capas complementarias de un ecosistema y no en otra promesa abstracta.
Modos de falla y recuperación
La lectura práctica de el stack operativo de una organización digital mediana comienza con esta observación: Un stack es un conjunto de responsabilidades antes que un conjunto de tecnologías. En la sección «Modos de falla y recuperación», importa porque qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. La evidencia que hay que mirar incluye registros de decisiones, límites de producto, señales de entrega y resultados; sin ella, el equipo puede confundir una explicación atractiva con una confiable. Un movimiento operativo útil es definir ownership por decisión y modo de falla, no por nombre de herramienta. Así, interfaces claras entre research, producto, ingeniería y servicio continuo adquiere un límite visible, se vuelve posible observar tiempo de pasar un insight verificado a capacidad confiable para clientes y se conserva la oportunidad de revisar la conclusión cuando el stack se vuelva lista de proveedores sin modelo operativo.
Un sistema se vuelve concreto cuando se prueba en una situación como una organización que coordina plataforma, servicio y research. En ese escenario, Las interfaces aclaran dónde puede fallar una entrega y quién la recupera. Por eso el equipo debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad antes de elegir herramienta, modelo o reunión. interfaces claras entre research, producto, ingeniería y servicio continuo importa porque convierte una ambición difusa en una secuencia inspeccionable. La acción recomendada es definir ownership por decisión y modo de falla, no por nombre de herramienta y después comparar el resultado con registros de decisiones, límites de producto, señales de entrega y resultados. Si el resultado no se puede explicar, el problema no es solo de ejecución: puede ser que el stack se vuelva lista de proveedores sin modelo operativo.
La capa de evidencia cambia la calidad de la decisión. Aquí, registros de decisiones, límites de producto, señales de entrega y resultados debe tratarse como material de revisión y no como decoración de una respuesta ya elegida. Research es parte de operaciones cuando las decisiones se repiten y la evidencia se acumula. Un equipo cuidadoso registra qué esperaba, qué observó y qué sigue abierto. Después utiliza tiempo de pasar un insight verificado a capacidad confiable para clientes como señal de aprendizaje y no como insignia. Esto importa especialmente cuando una organización que coordina plataforma, servicio y research, porque las restricciones locales pueden exponer supuestos razonables solo en apariencia.
Implementar no significa correr del concepto al software. Significa elegir una acción acotada: definir ownership por decisión y modo de falla, no por nombre de herramienta. La razón es sencilla: interfaces claras entre research, producto, ingeniería y servicio continuo solo merece confianza cuando cada transición tiene responsable y condición visible. La confiabilidad pertenece a la promesa de producto, no a una narrativa técnica aparte. En la práctica, el equipo debe proteger un punto pequeño de revisión antes de ampliar alcance. Esa revisión debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, inspeccionar registros de decisiones, límites de producto, señales de entrega y resultados y registrar si cambió tiempo de pasar un insight verificado a capacidad confiable para clientes. De lo contrario, el stack se vuelva lista de proveedores sin modelo operativo puede descubrirse cuando cambiar ya es costoso.
El contraargumento merece una escucha justa. Un equipo puede decir que el stack operativo de una organización digital mediana es demasiado matizado para un método repetible o que documentar ralentiza el trabajo. La respuesta no es quitar estructura, sino mantenerla proporcional a la consecuencia. Un ecosistema coherente facilita la siguiente capa sin ocultar sus límites. La versión mínima necesita una pregunta, un responsable, una fuente u observación, una decisión y un camino de regreso. Con eso basta para volver real Inferent y Arcadia como capas complementarias de un ecosistema mientras se reconoce que el stack se vuelva lista de proveedores sin modelo operativo. También protege tiempo de pasar un insight verificado a capacidad confiable para clientes de convertirse en un número separado de la práctica.
La lección durable de esta sección es que el mejor diagrama de arquitectura ayuda a decidir quién actúa después. El equipo puede traducirla en una regla de trabajo: partir de qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, hacer accesible registros de decisiones, límites de producto, señales de entrega y resultados, organizar el trabajo mediante interfaces claras entre research, producto, ingeniería y servicio continuo y revisar tiempo de pasar un insight verificado a capacidad confiable para clientes después de actuar. Cuando ocurre una organización que coordina plataforma, servicio y research, la regla ofrece una forma compartida de discrepar sin perder impulso. Convierte el stack operativo de una organización digital mediana en Inferent y Arcadia como capas complementarias de un ecosistema y no en otra promesa abstracta.
Diseñar para contextos distintos
La lectura práctica de el stack operativo de una organización digital mediana comienza con esta observación: Un stack es un conjunto de responsabilidades antes que un conjunto de tecnologías. En la sección «Diseñar para contextos distintos», importa porque qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. La evidencia que hay que mirar incluye registros de decisiones, límites de producto, señales de entrega y resultados; sin ella, el equipo puede confundir una explicación atractiva con una confiable. Un movimiento operativo útil es definir ownership por decisión y modo de falla, no por nombre de herramienta. Así, interfaces claras entre research, producto, ingeniería y servicio continuo adquiere un límite visible, se vuelve posible observar tiempo de pasar un insight verificado a capacidad confiable para clientes y se conserva la oportunidad de revisar la conclusión cuando el stack se vuelva lista de proveedores sin modelo operativo.
Un sistema se vuelve concreto cuando se prueba en una situación como una organización que coordina plataforma, servicio y research. En ese escenario, Las interfaces aclaran dónde puede fallar una entrega y quién la recupera. Por eso el equipo debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad antes de elegir herramienta, modelo o reunión. interfaces claras entre research, producto, ingeniería y servicio continuo importa porque convierte una ambición difusa en una secuencia inspeccionable. La acción recomendada es definir ownership por decisión y modo de falla, no por nombre de herramienta y después comparar el resultado con registros de decisiones, límites de producto, señales de entrega y resultados. Si el resultado no se puede explicar, el problema no es solo de ejecución: puede ser que el stack se vuelva lista de proveedores sin modelo operativo.
La capa de evidencia cambia la calidad de la decisión. Aquí, registros de decisiones, límites de producto, señales de entrega y resultados debe tratarse como material de revisión y no como decoración de una respuesta ya elegida. Research es parte de operaciones cuando las decisiones se repiten y la evidencia se acumula. Un equipo cuidadoso registra qué esperaba, qué observó y qué sigue abierto. Después utiliza tiempo de pasar un insight verificado a capacidad confiable para clientes como señal de aprendizaje y no como insignia. Esto importa especialmente cuando una organización que coordina plataforma, servicio y research, porque las restricciones locales pueden exponer supuestos razonables solo en apariencia.
Implementar no significa correr del concepto al software. Significa elegir una acción acotada: definir ownership por decisión y modo de falla, no por nombre de herramienta. La razón es sencilla: interfaces claras entre research, producto, ingeniería y servicio continuo solo merece confianza cuando cada transición tiene responsable y condición visible. La confiabilidad pertenece a la promesa de producto, no a una narrativa técnica aparte. En la práctica, el equipo debe proteger un punto pequeño de revisión antes de ampliar alcance. Esa revisión debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, inspeccionar registros de decisiones, límites de producto, señales de entrega y resultados y registrar si cambió tiempo de pasar un insight verificado a capacidad confiable para clientes. De lo contrario, el stack se vuelva lista de proveedores sin modelo operativo puede descubrirse cuando cambiar ya es costoso.
El contraargumento merece una escucha justa. Un equipo puede decir que el stack operativo de una organización digital mediana es demasiado matizado para un método repetible o que documentar ralentiza el trabajo. La respuesta no es quitar estructura, sino mantenerla proporcional a la consecuencia. Un ecosistema coherente facilita la siguiente capa sin ocultar sus límites. La versión mínima necesita una pregunta, un responsable, una fuente u observación, una decisión y un camino de regreso. Con eso basta para volver real Inferent y Arcadia como capas complementarias de un ecosistema mientras se reconoce que el stack se vuelva lista de proveedores sin modelo operativo. También protege tiempo de pasar un insight verificado a capacidad confiable para clientes de convertirse en un número separado de la práctica.
La lección durable de esta sección es que el mejor diagrama de arquitectura ayuda a decidir quién actúa después. El equipo puede traducirla en una regla de trabajo: partir de qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, hacer accesible registros de decisiones, límites de producto, señales de entrega y resultados, organizar el trabajo mediante interfaces claras entre research, producto, ingeniería y servicio continuo y revisar tiempo de pasar un insight verificado a capacidad confiable para clientes después de actuar. Cuando ocurre una organización que coordina plataforma, servicio y research, la regla ofrece una forma compartida de discrepar sin perder impulso. Convierte el stack operativo de una organización digital mediana en Inferent y Arcadia como capas complementarias de un ecosistema y no en otra promesa abstracta.
La mirada de Inferent / Arcadia
La lectura práctica de el stack operativo de una organización digital mediana comienza con esta observación: Un stack es un conjunto de responsabilidades antes que un conjunto de tecnologías. En la sección «La mirada de Inferent / Arcadia», importa porque qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. La evidencia que hay que mirar incluye registros de decisiones, límites de producto, señales de entrega y resultados; sin ella, el equipo puede confundir una explicación atractiva con una confiable. Un movimiento operativo útil es definir ownership por decisión y modo de falla, no por nombre de herramienta. Así, interfaces claras entre research, producto, ingeniería y servicio continuo adquiere un límite visible, se vuelve posible observar tiempo de pasar un insight verificado a capacidad confiable para clientes y se conserva la oportunidad de revisar la conclusión cuando el stack se vuelva lista de proveedores sin modelo operativo.
Un sistema se vuelve concreto cuando se prueba en una situación como una organización que coordina plataforma, servicio y research. En ese escenario, Las interfaces aclaran dónde puede fallar una entrega y quién la recupera. Por eso el equipo debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad antes de elegir herramienta, modelo o reunión. interfaces claras entre research, producto, ingeniería y servicio continuo importa porque convierte una ambición difusa en una secuencia inspeccionable. La acción recomendada es definir ownership por decisión y modo de falla, no por nombre de herramienta y después comparar el resultado con registros de decisiones, límites de producto, señales de entrega y resultados. Si el resultado no se puede explicar, el problema no es solo de ejecución: puede ser que el stack se vuelva lista de proveedores sin modelo operativo.
La capa de evidencia cambia la calidad de la decisión. Aquí, registros de decisiones, límites de producto, señales de entrega y resultados debe tratarse como material de revisión y no como decoración de una respuesta ya elegida. Research es parte de operaciones cuando las decisiones se repiten y la evidencia se acumula. Un equipo cuidadoso registra qué esperaba, qué observó y qué sigue abierto. Después utiliza tiempo de pasar un insight verificado a capacidad confiable para clientes como señal de aprendizaje y no como insignia. Esto importa especialmente cuando una organización que coordina plataforma, servicio y research, porque las restricciones locales pueden exponer supuestos razonables solo en apariencia.
Implementar no significa correr del concepto al software. Significa elegir una acción acotada: definir ownership por decisión y modo de falla, no por nombre de herramienta. La razón es sencilla: interfaces claras entre research, producto, ingeniería y servicio continuo solo merece confianza cuando cada transición tiene responsable y condición visible. La confiabilidad pertenece a la promesa de producto, no a una narrativa técnica aparte. En la práctica, el equipo debe proteger un punto pequeño de revisión antes de ampliar alcance. Esa revisión debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, inspeccionar registros de decisiones, límites de producto, señales de entrega y resultados y registrar si cambió tiempo de pasar un insight verificado a capacidad confiable para clientes. De lo contrario, el stack se vuelva lista de proveedores sin modelo operativo puede descubrirse cuando cambiar ya es costoso.
El contraargumento merece una escucha justa. Un equipo puede decir que el stack operativo de una organización digital mediana es demasiado matizado para un método repetible o que documentar ralentiza el trabajo. La respuesta no es quitar estructura, sino mantenerla proporcional a la consecuencia. Un ecosistema coherente facilita la siguiente capa sin ocultar sus límites. La versión mínima necesita una pregunta, un responsable, una fuente u observación, una decisión y un camino de regreso. Con eso basta para volver real Inferent y Arcadia como capas complementarias de un ecosistema mientras se reconoce que el stack se vuelva lista de proveedores sin modelo operativo. También protege tiempo de pasar un insight verificado a capacidad confiable para clientes de convertirse en un número separado de la práctica.
La lección durable de esta sección es que el mejor diagrama de arquitectura ayuda a decidir quién actúa después. El equipo puede traducirla en una regla de trabajo: partir de qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, hacer accesible registros de decisiones, límites de producto, señales de entrega y resultados, organizar el trabajo mediante interfaces claras entre research, producto, ingeniería y servicio continuo y revisar tiempo de pasar un insight verificado a capacidad confiable para clientes después de actuar. Cuando ocurre una organización que coordina plataforma, servicio y research, la regla ofrece una forma compartida de discrepar sin perder impulso. Convierte el stack operativo de una organización digital mediana en Inferent y Arcadia como capas complementarias de un ecosistema y no en otra promesa abstracta.
Una ruta de implementación reversible
La lectura práctica de el stack operativo de una organización digital mediana comienza con esta observación: Un stack es un conjunto de responsabilidades antes que un conjunto de tecnologías. En la sección «Una ruta de implementación reversible», importa porque qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. La evidencia que hay que mirar incluye registros de decisiones, límites de producto, señales de entrega y resultados; sin ella, el equipo puede confundir una explicación atractiva con una confiable. Un movimiento operativo útil es definir ownership por decisión y modo de falla, no por nombre de herramienta. Así, interfaces claras entre research, producto, ingeniería y servicio continuo adquiere un límite visible, se vuelve posible observar tiempo de pasar un insight verificado a capacidad confiable para clientes y se conserva la oportunidad de revisar la conclusión cuando el stack se vuelva lista de proveedores sin modelo operativo.
Un sistema se vuelve concreto cuando se prueba en una situación como una organización que coordina plataforma, servicio y research. En ese escenario, Las interfaces aclaran dónde puede fallar una entrega y quién la recupera. Por eso el equipo debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad antes de elegir herramienta, modelo o reunión. interfaces claras entre research, producto, ingeniería y servicio continuo importa porque convierte una ambición difusa en una secuencia inspeccionable. La acción recomendada es definir ownership por decisión y modo de falla, no por nombre de herramienta y después comparar el resultado con registros de decisiones, límites de producto, señales de entrega y resultados. Si el resultado no se puede explicar, el problema no es solo de ejecución: puede ser que el stack se vuelva lista de proveedores sin modelo operativo.
La capa de evidencia cambia la calidad de la decisión. Aquí, registros de decisiones, límites de producto, señales de entrega y resultados debe tratarse como material de revisión y no como decoración de una respuesta ya elegida. Research es parte de operaciones cuando las decisiones se repiten y la evidencia se acumula. Un equipo cuidadoso registra qué esperaba, qué observó y qué sigue abierto. Después utiliza tiempo de pasar un insight verificado a capacidad confiable para clientes como señal de aprendizaje y no como insignia. Esto importa especialmente cuando una organización que coordina plataforma, servicio y research, porque las restricciones locales pueden exponer supuestos razonables solo en apariencia.
Implementar no significa correr del concepto al software. Significa elegir una acción acotada: definir ownership por decisión y modo de falla, no por nombre de herramienta. La razón es sencilla: interfaces claras entre research, producto, ingeniería y servicio continuo solo merece confianza cuando cada transición tiene responsable y condición visible. La confiabilidad pertenece a la promesa de producto, no a una narrativa técnica aparte. En la práctica, el equipo debe proteger un punto pequeño de revisión antes de ampliar alcance. Esa revisión debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, inspeccionar registros de decisiones, límites de producto, señales de entrega y resultados y registrar si cambió tiempo de pasar un insight verificado a capacidad confiable para clientes. De lo contrario, el stack se vuelva lista de proveedores sin modelo operativo puede descubrirse cuando cambiar ya es costoso.
El contraargumento merece una escucha justa. Un equipo puede decir que el stack operativo de una organización digital mediana es demasiado matizado para un método repetible o que documentar ralentiza el trabajo. La respuesta no es quitar estructura, sino mantenerla proporcional a la consecuencia. Un ecosistema coherente facilita la siguiente capa sin ocultar sus límites. La versión mínima necesita una pregunta, un responsable, una fuente u observación, una decisión y un camino de regreso. Con eso basta para volver real Inferent y Arcadia como capas complementarias de un ecosistema mientras se reconoce que el stack se vuelva lista de proveedores sin modelo operativo. También protege tiempo de pasar un insight verificado a capacidad confiable para clientes de convertirse en un número separado de la práctica.
La lección durable de esta sección es que el mejor diagrama de arquitectura ayuda a decidir quién actúa después. El equipo puede traducirla en una regla de trabajo: partir de qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, hacer accesible registros de decisiones, límites de producto, señales de entrega y resultados, organizar el trabajo mediante interfaces claras entre research, producto, ingeniería y servicio continuo y revisar tiempo de pasar un insight verificado a capacidad confiable para clientes después de actuar. Cuando ocurre una organización que coordina plataforma, servicio y research, la regla ofrece una forma compartida de discrepar sin perder impulso. Convierte el stack operativo de una organización digital mediana en Inferent y Arcadia como capas complementarias de un ecosistema y no en otra promesa abstracta.
Conclusión editorial
La lectura práctica de el stack operativo de una organización digital mediana comienza con esta observación: Un stack es un conjunto de responsabilidades antes que un conjunto de tecnologías. En la sección «Conclusión editorial», importa porque qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad. La evidencia que hay que mirar incluye registros de decisiones, límites de producto, señales de entrega y resultados; sin ella, el equipo puede confundir una explicación atractiva con una confiable. Un movimiento operativo útil es definir ownership por decisión y modo de falla, no por nombre de herramienta. Así, interfaces claras entre research, producto, ingeniería y servicio continuo adquiere un límite visible, se vuelve posible observar tiempo de pasar un insight verificado a capacidad confiable para clientes y se conserva la oportunidad de revisar la conclusión cuando el stack se vuelva lista de proveedores sin modelo operativo.
Un sistema se vuelve concreto cuando se prueba en una situación como una organización que coordina plataforma, servicio y research. En ese escenario, Las interfaces aclaran dónde puede fallar una entrega y quién la recupera. Por eso el equipo debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad antes de elegir herramienta, modelo o reunión. interfaces claras entre research, producto, ingeniería y servicio continuo importa porque convierte una ambición difusa en una secuencia inspeccionable. La acción recomendada es definir ownership por decisión y modo de falla, no por nombre de herramienta y después comparar el resultado con registros de decisiones, límites de producto, señales de entrega y resultados. Si el resultado no se puede explicar, el problema no es solo de ejecución: puede ser que el stack se vuelva lista de proveedores sin modelo operativo.
La capa de evidencia cambia la calidad de la decisión. Aquí, registros de decisiones, límites de producto, señales de entrega y resultados debe tratarse como material de revisión y no como decoración de una respuesta ya elegida. Research es parte de operaciones cuando las decisiones se repiten y la evidencia se acumula. Un equipo cuidadoso registra qué esperaba, qué observó y qué sigue abierto. Después utiliza tiempo de pasar un insight verificado a capacidad confiable para clientes como señal de aprendizaje y no como insignia. Esto importa especialmente cuando una organización que coordina plataforma, servicio y research, porque las restricciones locales pueden exponer supuestos razonables solo en apariencia.
Implementar no significa correr del concepto al software. Significa elegir una acción acotada: definir ownership por decisión y modo de falla, no por nombre de herramienta. La razón es sencilla: interfaces claras entre research, producto, ingeniería y servicio continuo solo merece confianza cuando cada transición tiene responsable y condición visible. La confiabilidad pertenece a la promesa de producto, no a una narrativa técnica aparte. En la práctica, el equipo debe proteger un punto pequeño de revisión antes de ampliar alcance. Esa revisión debe preguntar qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, inspeccionar registros de decisiones, límites de producto, señales de entrega y resultados y registrar si cambió tiempo de pasar un insight verificado a capacidad confiable para clientes. De lo contrario, el stack se vuelva lista de proveedores sin modelo operativo puede descubrirse cuando cambiar ya es costoso.
El contraargumento merece una escucha justa. Un equipo puede decir que el stack operativo de una organización digital mediana es demasiado matizado para un método repetible o que documentar ralentiza el trabajo. La respuesta no es quitar estructura, sino mantenerla proporcional a la consecuencia. Un ecosistema coherente facilita la siguiente capa sin ocultar sus límites. La versión mínima necesita una pregunta, un responsable, una fuente u observación, una decisión y un camino de regreso. Con eso basta para volver real Inferent y Arcadia como capas complementarias de un ecosistema mientras se reconoce que el stack se vuelva lista de proveedores sin modelo operativo. También protege tiempo de pasar un insight verificado a capacidad confiable para clientes de convertirse en un número separado de la práctica.
La lección durable de esta sección es que el mejor diagrama de arquitectura ayuda a decidir quién actúa después. El equipo puede traducirla en una regla de trabajo: partir de qué capa posee la evidencia, cuál la experiencia y cuál la confiabilidad, hacer accesible registros de decisiones, límites de producto, señales de entrega y resultados, organizar el trabajo mediante interfaces claras entre research, producto, ingeniería y servicio continuo y revisar tiempo de pasar un insight verificado a capacidad confiable para clientes después de actuar. Cuando ocurre una organización que coordina plataforma, servicio y research, la regla ofrece una forma compartida de discrepar sin perder impulso. Convierte el stack operativo de una organización digital mediana en Inferent y Arcadia como capas complementarias de un ecosistema y no en otra promesa abstracta.
Siguiente pasada de revisión
definir ownership por decisión y modo de falla, no por nombre de herramienta registros de decisiones, límites de producto, señales de entrega y resultados. A reviewer should verify tiempo de pasar un insight verificado a capacidad confiable para clientes and ask whether el stack se vuelva lista de proveedores sin modelo operativo remains plausible. Inferent y Arcadia como capas complementarias de un ecosistema is ready for the next editorial pass when the claim, owner, source path and correction route are all visible.